동작 원리
- 입력걷기 목표와 현재 몸 상태
목표 속도 + 로봇 상태가상 로봇마다 목표 속도와 현재의 움직임 정보가 주어집니다.
- 처리움직이고 보상으로 배우기
정책 → 관절 목표 → Newton → 보상Newton이 움직임을 계산하고, RSL-RL은 얼마나 잘 걸었는지를 보상으로 받아 정책을 업데이트합니다.
- 출력배운 정책을 저장하고 재생
model_499.pt · 학습 로그체크포인트에는 학습된 모델 값이, 로그에는 보상과 한 시도가 얼마나 이어졌는지가 남습니다.
움직인 뒤의 상태로 다음 동작을 정하고, 한 시도가 끝나면 다시 시작합니다.
무엇을 보고 발을 움직일까요?
Isaac Lab의 과제는 로봇에게 목표 속도를 주고, 로봇 자세와 움직임을 관측값으로 구성합니다. 정책은 숫자로 표현된 관측값을 읽고 관절에 보낼 동작을 계산합니다. Newton은 발이 바닥에 닿는 위치와 힘, 몸이 균형을 잃는지 등을 물리적으로 계산합니다. 다음 스텝에서는 그 결과가 새 관측값이 됩니다. Isaac Lab Microduck 설정
512개 연습장에서 한 정책이 배우는 과정
이 실습은 512개 환경에서 같은 정책을 실행해 여러 관측·행동·보상 기록을 모읍니다. 보상은 목표 속도 추종 같은 동작이 과제의 기준에 얼마나 맞았는지를 나타내는 숫자입니다. RSL-RL은 모은 경험으로 정책의 가중치를 갱신합니다. 종료 조건을 충족하거나 시간 제한에 도달한 에피소드는 초기화해 다음 시도를 시작합니다. NVIDIA의 Microduck 학습 파이프라인
{ "iteration": 499, "mean_reward": 32.69, "mean_episode_length": 421.18 }
위 값은 테스트 기록에서 마지막 학습 반복의 일부입니다. mean_reward는 과제 보상이고 mean_episode_length는 평균 스텝 수입니다. 보행 속도나 초 단위의 시간으로 그대로 읽지 않습니다. 재생은 model_499.pt의 학습된 가중치를 사용해 새 관측마다 동작을 정합니다. 별도의 ONNX 파일은 내보낸 정책이며, 시뮬레이션 재생은 실제 로봇에서의 검증과 구분합니다.
처음이면 실습 파일부터 받기
GPU 실습은 Isaac Sim을 실행할 머신에서 터미널을 엽니다. CPU 실습은 지금 쓰는 컴퓨터에서 해도 됩니다. 아래 명령은 한 줄씩 입력하고 Enter를 누르세요. 여러 줄짜리 명령 블록은 통째로 복사해도 됩니다.
cd "$HOME"
git clone https://github.com/james-joobs/awesome-nvidia-physical-ai.git
cd awesome-nvidia-physical-ai
pwd
홈 폴더에 받는 예입니다. 이미 내려받았다면 git clone은 건너뛰고 내 실습 폴더로 이동합니다. 새 터미널을 열 때마다 pwd의 출력 끝이 awesome-nvidia-physical-ai인지 확인하세요. 그래야 labs/로 시작하는 파일을 찾을 수 있습니다.
따라 하기
준비물 · 새 학습은 RTX 머신에서 합니다. NVIDIA Microduck 설정을 따라 Isaac Lab d7e49f0 환경과 uv를 준비합니다. 아래는 Isaac Lab을 홈 폴더에 받았다는 예입니다.
1. 보행 정책 학습하기
이 레포 폴더에서 터미널을 엽니다. Isaac Lab을 다른 곳에 받았다면 첫 줄의 경로를 바꾸세요. 학습 중에는 터미널에 반복 횟수와 보상이 표시됩니다. 이 예제는 가상 환경 512개로 500회 학습합니다.
ISAAC_LAB_DIR="$HOME/IsaacLab"
bash labs/microduck/train.sh "$ISAAC_LAB_DIR"
2. 학습을 마친 로봇 재생하기
프롬프트가 돌아오면 로그에 나온 model_499.pt 경로를 확인합니다. 아래 첫 줄의 예시를 내 파일의 전체 경로로 바꾼 뒤, 같은 터미널에서 두 줄을 실행합니다. 재생은 학습된 정책으로 가상 로봇을 걷게 합니다.
CHECKPOINT="/실제/학습/폴더/model_499.pt"
bash labs/microduck/play.sh "$ISAAC_LAB_DIR" "$CHECKPOINT"
함께 제공하는 ONNX 파일은 다른 런타임으로 내보낸 모델입니다. 위 Isaac Lab 재생에서는 학습으로 생성한 .pt 파일을 사용합니다. 공개 모델은 가중치가 포함된 단일 파일이며 디버그 메타데이터를 제거했습니다. 관측값 61개를 받아 관절 목표값 14개를 출력합니다. 별도 환경에 onnxruntime==1.32.0을 설치한 뒤 python labs/microduck/check_policy.py로 GPU 없이 입출력을 확인할 수 있습니다. 원본 내보내기 결과와의 비교는 검사 기록에 남겼습니다.
테스트 결과
내 실행에서는 보상이 학습 초반보다 올라가는지, 로봇이 목표 속도로 걷는지 확인합니다. 보상은 주어진 목표를 얼마나 잘 따랐는지 나타내는 점수입니다.
GPU 없이 기존 학습 기록 읽기 · 이 레포 폴더에서 아래 명령을 실행합니다. 학습을 다시 돌리지 않고 저장된 로그의 앞·뒤 50회 평균을 계산합니다.
python3 labs/microduck/read_training.py labs/microduck/training-metrics.txt ./runs/microduck-metrics
촬영 당시 평균 보상은 0.65에서 23.46으로, 에피소드 길이는 35.50스텝에서 320.94스텝으로 늘었습니다. 촬영 당시 학습 기록
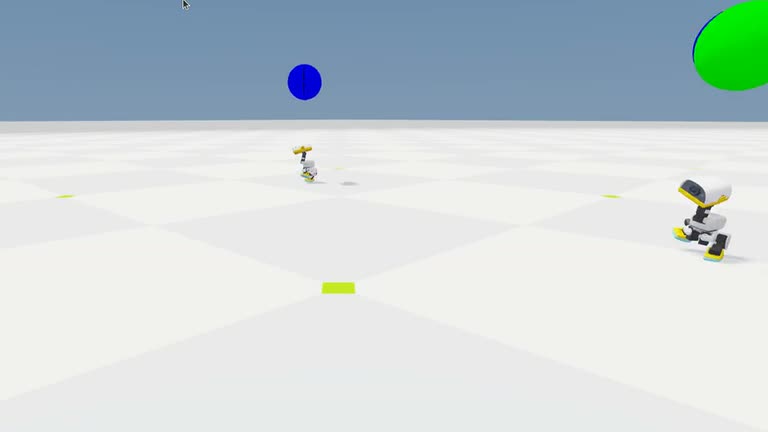
실행 영상과 기록
실습 소스 코드
train.sh
GitHub에서 파일 보기#!/usr/bin/env bash
set -euo pipefail
if [[ $# != 1 ]]; then
printf 'Usage: bash %s ISAAC_LAB_CHECKOUT\n' "$0" >&2
exit 2
fi
cd "$1"
uv run --no-sync isaaclab train --rl_library rsl_rl \
--task IsaacContrib-Velocity-Flat-MicroDuck --num_envs 512 --max_iterations 500 \
--seed 17 --run_name showcase_microduck presets=backlash
play.sh
GitHub에서 파일 보기#!/usr/bin/env bash
set -euo pipefail
if [[ $# != 2 ]]; then
printf 'Usage: bash %s ISAAC_LAB_CHECKOUT CHECKPOINT_PT\n' "$0" >&2
exit 2
fi
checkpoint="$(cd "$(dirname "$2")" && pwd -P)/$(basename "$2")"
test -s "$checkpoint"
cd "$1"
uv run --no-sync isaaclab play --rl_library rsl_rl \
--task IsaacContrib-Velocity-Flat-MicroDuck --checkpoint "$checkpoint" --num_envs 4 \
--viz newton_gl presets=backlash 'env.viewer.eye=[2.1,-2.3,1.35]' 'env.viewer.lookat=[0,0,0.24]'
read_training.py
GitHub에서 파일 보기"""Summarize the warm-up and final training windows from the GPU workstation Microduck run."""
import argparse
import json
import re
import statistics
from pathlib import Path
ANSI = re.compile(r"\x1b\[[0-?]*[ -/]*[@-~]")
ITERATION = re.compile(r"Learning iteration\s+(\d+)/\d+")
SECTIONS = {
"mean_reward": re.compile(r"Mean reward:\s+(-?\d+\.\d+)"),
"mean_episode_length": re.compile(r"Mean episode length:\s+(\d+\.\d+)"),
}
def main():
parser = argparse.ArgumentParser(description=__doc__)
parser.add_argument("log", type=Path)
parser.add_argument("output", type=Path)
args = parser.parse_args()
args.output.mkdir(parents=True, exist_ok=True)
log = ANSI.sub("", args.log.read_text())
blocks = ITERATION.split(log)
rows = []
for step, block in zip(blocks[1::2], blocks[2::2], strict=True):
entry = {"iteration": int(step)}
for key, pattern in SECTIONS.items():
match = pattern.search(block)
if match is None:
raise ValueError(f"Missing {key} for training iteration {step}")
entry[key] = float(match.group(1))
rows.append(entry)
assert [row["iteration"] for row in rows] == list(range(500))
windows = {"first_50": rows[:50], "last_50": rows[-50:]}
aggregate = {name: {key: statistics.mean(row[key] for row in selected) for key in SECTIONS} for name, selected in windows.items()}
print(f"Microduck | {len(rows)} iterations | {aggregate}", flush=True)
(args.output / "result.json").write_text(json.dumps({
"scope": "training statistics logged by RSL-RL for one run",
"environments": 512, "iteration_count": len(rows), "windows": aggregate, "iterations": rows,
}, indent=2) + "\n")
if __name__ == "__main__":
main()