별도 심화 실습 · Isaac Sim 6.1과 Isaac Lab에서 예제 USD와 전용 검사 코드로 960 × 540 데이터를 생성합니다. 처음 카메라 데이터를 만든다면 Isaac Sim 6.2 작업대 완주 과제부터 시작하세요.
동작 원리
- 입력장면과 카메라 한 대
replicator-live.usda · /World/SensorCameraUSD 파일에 큐브, 조명, 촬영할 카메라가 들어 있습니다.
- 처리한 화면에서 세 가지 읽기
RGB · 카메라 기준 깊이 · 클래스 번호같은 픽셀에서 색, 카메라 평면으로부터의 거리, 어떤 물체인지 읽습니다.
- 출력프레임별 결과 폴더
rgb.png · depth_m.npy · semantic_ids.npyPNG는 색, 배열은 미터 단위 깊이와 클래스 번호를 담습니다. 번호의 뜻은 JSON에 적혀 있습니다.
같은 화면을 색·깊이·라벨로 읽기
Replicator의 렌더 프로덕트는 촬영할 USD 카메라와 해상도를 묶습니다. 스크립트는 여기에 색상, 카메라 평면 기준 깊이, 의미 분할을 읽는 어노테이터 세 개를 연결합니다. 프레임마다 큐브의 위치·조명·카메라 설정이나 가림 조건을 바꾸고, 같은 렌더 결과에서 세 데이터를 저장합니다. 분할 번호는 USD에 붙인 클래스 라벨에서 나옵니다. Isaac Sim 공식 캡처 예제 · 이 실습의 촬영 코드
프레임 폴더에서 같은 픽셀 찾기
| 파일 | 이 실습에서 읽는 모양 | 값의 뜻 |
|---|---|---|
rgb.png |
[540, 960, 3], uint8 |
한 픽셀의 빨강·초록·파랑 값. 각 값은 0~255입니다. |
depth_m.npy |
[540, 960], float32 |
카메라 앞 방향으로 잰 깊이(m). 카메라 중심에서 픽셀 표면까지의 직선거리와는 값이 다를 수 있습니다. |
semantic_ids.npy |
[540, 960], uint32 |
각 픽셀에 해당하는 클래스 번호입니다. |
semantic_labels.json |
번호 → 라벨 | 예를 들어 target에 해당하는 번호를 찾아 큐브 픽셀만 골라냅니다. |
이미지 좌표 (u, v)는 왼쪽 위가 원점이며 오른쪽과 아래로 증가합니다. NumPy에서는 행을 먼저 쓰므로 같은 점을 rgb[v, u], depth[v, u], ids[v, u]로 읽습니다. 같은 클래스가 여러 물체에 붙어 있다면 의미 분할은 같은 이름으로 묶습니다. 개별 물체를 구분해야 한다면 인스턴스 분할을 사용합니다.
마스크에서 상자가 어떻게 나올까요?
target인 픽셀만 남기고 왼쪽·위·오른쪽·아래 끝을 읽으면 경계 상자를 계산할 수 있습니다. 실행 기록의 프레임 0에서 실제 상자는 [264, 159, 401, 292]이고, 큐브로 분류된 픽셀은 15121개입니다. 이 예제의 끝 좌표는 포함됩니다. 상자의 크기는 138 × 134픽셀이지만 안에 배경도 들어가므로, 실제로 보이는 면적을 구할 때는 마스크의 픽셀 수를 사용합니다.
가림 조건의 프레임 3에서는 target_pixels가 4102입니다. 프레임 설정에서 위치도 달라지므로 두 프레임의 차이를 가림의 효과만으로 해석할 수는 없습니다. 가림만 비교하고 싶다면 카메라와 큐브 위치를 고정한 뒤 가림막 유무만 바꿔 보세요.
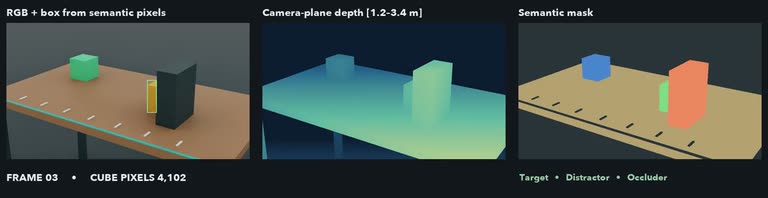
프레임 3에서 경계 상자는 화면에 드러난 큐브 픽셀만 감쌉니다. 큐브의 나머지 부분은 가림막 뒤에 있습니다. 미리보기 생성 코드
처음이면 실습 파일부터 받기
GPU 실습은 Isaac Sim을 실행할 머신에서 터미널을 엽니다. CPU 실습은 지금 쓰는 컴퓨터에서 해도 됩니다. 아래 명령은 한 줄씩 입력하고 Enter를 누르세요. 여러 줄짜리 명령 블록은 통째로 복사해도 됩니다.
cd "$HOME"
git clone https://github.com/james-joobs/awesome-nvidia-physical-ai.git
cd awesome-nvidia-physical-ai
pwd
홈 폴더에 받는 예입니다. 이미 내려받았다면 git clone은 건너뛰고 내 실습 폴더로 이동합니다. 새 터미널을 열 때마다 pwd의 출력 끝이 awesome-nvidia-physical-ai인지 확인하세요. 그래야 labs/로 시작하는 파일을 찾을 수 있습니다.
따라 하기
준비물 · RTX 머신에서 Isaac Sim 6.1과 연결된 Isaac Lab Python 환경을 활성화합니다. 설치 방식과 실행 환경을 먼저 확인하세요. 이 예제는 Isaac Lab의 앱 실행기를 사용하므로 일반 Python에 NumPy만 설치한 환경으로는 캡처할 수 없습니다.
1. 장면을 열고 캡처하기
시뮬레이터를 실행할 머신의 터미널에서 이 레포 폴더로 이동합니다. 첫 경로는 읽을 USD이고, 두 번째는 결과를 저장할 폴더입니다. --viz kit를 붙이면 창에서 장면을 볼 수 있습니다. 같은 실습을 다시 할 때는 출력 폴더를 새 이름으로 바꾸세요.
python labs/replicator-outputs/capture.py \
  labs/replicator-outputs/replicator-live.usda ./runs/replicator --viz kit
2. 프레임 하나의 파일을 나란히 보기
실행이 끝나면 같은 터미널에서 아래 명령을 실행합니다. rgb.png는 이미지 뷰어로, semantic_labels.json은 텍스트 편집기로 열어 보세요. .npy 두 개는 숫자 배열이므로 검사 코드가 읽습니다. 검사 코드는 색·깊이·분할이 같은 크기인지, 큐브 픽셀의 깊이값이 정상인지 확인합니다.
ls ./runs/replicator/frames/00
python labs/replicator-outputs/check_capture.py ./runs/replicator
FFmpeg가 설치돼 있다면 python labs/replicator-outputs/preview_dataset.py ./runs/replicator로 세 채널을 나란히 보는 미리보기도 만들 수 있습니다. NVIDIA Replicator 튜토리얼
테스트 결과
960 × 540 데이터 12세트가 생성됐습니다. 검사 코드는 배열 크기, RGB 해시, 분할 마스크의 큐브 픽셀 수를 기록과 비교하고, 큐브 위치의 깊이값이 유한한 양수인지 확인합니다. 가림판을 둔 03, 07, 11번 프레임에서는 큐브가 차지하는 픽셀 수가 줄었습니다. 촬영 당시 프레임 기록
실행 영상과 기록
실습 소스 코드
capture.py
GitHub에서 파일 보기"""Generate and record actual Replicator outputs from the Isaac Sim GUI."""
import argparse
import hashlib
import json
import os
from pathlib import Path
import signal
import subprocess
import time
import traceback
from isaaclab.app import AppLauncher
parser = argparse.ArgumentParser()
parser.add_argument("scene", type=Path)
parser.add_argument("output", type=Path)
parser.add_argument("--record-window", type=Path, metavar="FFMPEG",
help="Optional Linux X11 recording using this FFmpeg executable.")
AppLauncher.add_app_launcher_args(parser)
args = parser.parse_args()
args.enable_cameras = True
args.output.mkdir(parents=True, exist_ok=True)
app = AppLauncher(args).app
import carb
import numpy as np
import omni.replicator.core as rep
import omni.timeline
import omni.usd
from omni.kit.viewport.utility import get_active_viewport
from PIL import Image
from pxr import Gf, UsdGeom, UsdLux, UsdSemantics
WIDTH, HEIGHT = 960, 540
def update_for(seconds):
deadline = time.monotonic() + seconds
while time.monotonic() < deadline:
app.update()
def screen_recorder(log):
for line in subprocess.check_output(["xwininfo", "-root", "-tree"], text=True).splitlines():
if '"Isaac Lab ' in line and "mutter-x11-frames" not in line:
identifier = str(int(line.split()[0], 16))
break
else:
raise RuntimeError("Isaac Sim window not found")
return subprocess.Popen([
str(args.record_window), "-hide_banner", "-loglevel", "warning", "-y",
"-f", "x11grab", "-draw_mouse", "0", "-framerate", "30",
"-window_id", identifier, "-i", f"{os.environ['DISPLAY']}.0",
"-an", "-c:v", "libx264", "-preset", "ultrafast", "-crf", "18",
"-pix_fmt", "yuv420p", "-movflags", "+faststart", str(args.output / "replicator-gui.mp4"),
], stdin=subprocess.DEVNULL, stdout=log, stderr=subprocess.STDOUT)
def capture_dataset(stage, directory):
annotator_names = ("rgb", "distance_to_image_plane", "semantic_segmentation")
sensor = "/World/SensorCamera"
viewport = get_active_viewport()
viewport.camera_path = "/World/FilmCamera"
stage.SetEndTimeCode(900)
for path, category in (("/World/Target", "target"), ("/World/Distractor", "distractor"),
("/World/Occluder", "occluder"), ("/World/Workbench/Top", "workbench")):
UsdSemantics.LabelsAPI.Apply(stage.GetPrimAtPath(path), "class").CreateLabelsAttr([category])
assert stage.GetRootLayer().Export(str(args.output / "replicator-workbench.usda"))
target = UsdGeom.Xformable(stage.GetPrimAtPath("/World/Target")).GetOrderedXformOps()[0]
shield = UsdGeom.Xformable(stage.GetPrimAtPath("/World/Occluder")).GetOrderedXformOps()[0]
lens = UsdGeom.Xformable(stage.GetPrimAtPath(sensor)).GetOrderedXformOps()[0]
key = UsdLux.RectLight.Get(stage, "/World/Lighting/Key").GetIntensityAttr()
product = rep.create.render_product(sensor, (WIDTH, HEIGHT))
options = {"semantic_segmentation": {"colorize": False}}
annotators = {name: rep.AnnotatorRegistry.get_annotator(name, init_params=options[name])
if name in options else rep.AnnotatorRegistry.get_annotator(name) for name in annotator_names}
for annotator in annotators.values():
annotator.attach([product])
timeline = omni.timeline.get_timeline_interface()
timeline.play()
timeline.commit()
for _ in range(12):
update_for(.50)
live_rgb = np.asarray(annotators["rgb"].get_data())
if live_rgb.shape[:2] == (HEIGHT, WIDTH) and live_rgb[:, :, :3].mean() > 5:
break
else:
raise RuntimeError("Replicator RGB render product did not initialize")
shots = []
hashes = set()
with (args.output / "recorder.log").open("w") as log:
recorder = screen_recorder(log) if args.record_window else None
begin = time.monotonic()
try:
update_for(1.2)
for i in range(12):
x = (-.24, -.09, .08, .25)[i % 4]
energy = (950, 1550, 2300)[i // 4]
occluded = i % 4 == 3
target.Set(Gf.Vec3d(x, -.025, .87))
shield.Set(Gf.Vec3d(x+.10 if occluded else .43, -.113 if occluded else .12, .935))
key.Set(energy)
eye = Gf.Vec3d(1.10 + (i//4)*.13, -1.67, 1.60 + (i//4)*.07)
lens.Set(Gf.Matrix4d(1).SetLookAt(eye, Gf.Vec3d(0,0,.84), Gf.Vec3d(0,0,1)).GetInverse())
if i == 6:
viewport.camera_path = sensor
update_for(.72)
rgb = np.asarray(annotators["rgb"].get_data(), dtype=np.uint8)
depth = np.asarray(annotators["distance_to_image_plane"].get_data(), dtype=np.float32).squeeze()
segmentation = annotators["semantic_segmentation"].get_data()
ids = np.asarray(segmentation["data"], dtype=np.uint32).squeeze()
labels = segmentation["info"]["idToLabels"]
if isinstance(labels, str):
labels = json.loads(labels)
target_ids = [int(v) for v,label in labels.items() if (
label.get("class") if isinstance(label, dict) else label
) == "target"]
assert rgb.shape[:2] == depth.shape == ids.shape == (HEIGHT, WIDTH)
digest = hashlib.sha256(rgb[:, :, :3].tobytes()).hexdigest()
assert digest not in hashes, (i, "duplicate RGB buffer")
hashes.add(digest)
mask = np.isin(ids, target_ids)
if not occluded:
assert mask.sum() >= 100, (i, labels)
assert not np.isnan(depth[mask]).any() and np.isfinite(depth[mask]).all()
frame = directory / f"{i:02d}"
frame.mkdir()
Image.fromarray(rgb[:, :, :3]).save(frame / "rgb.png")
np.save(frame / "depth_m.npy", depth)
np.save(frame / "semantic_ids.npy", ids)
(frame / "semantic_labels.json").write_text(json.dumps(labels, indent=2) + "\n")
yy, xx = np.nonzero(mask)
bbox = None if len(xx) == 0 else [int(xx.min()), int(yy.min()), int(xx.max()), int(yy.max())]
info = {"frame": i, "target_x_m": x, "candidate_occluded": occluded, "key_light_intensity": energy,
"target_pixels": int(mask.sum()), "target_bbox_xyxy": bbox,
"target_median_depth_m": float(np.median(depth[mask])) if mask.any() else None,
"rgb_sha256": digest, "gui_wall_s": time.monotonic() - begin}
shots.append(info)
print(f"REPLICATOR_SAMPLE {i:02d} | RGB/DEPTH/IDS | {info['target_pixels']} target pixels", flush=True)
update_for(.37)
update_for(2)
finally:
if recorder:
recorder.send_signal(signal.SIGINT)
recorder.wait(timeout=14)
for annotator in annotators.values():
annotator.detach([product])
timeline.stop()
assert len(shots) == 12
(args.output / "result.json").write_text(json.dumps({
"resolution_px": [WIDTH, HEIGHT], "channels": list(annotators), "frames": shots,
}, indent=2) + "\n")
try:
settings = carb.settings.get_settings()
settings.set_bool("/omni/replicator/captureOnPlay", True)
settings.set_bool("/rtx/hydra/readTransformsFromFabricInRenderDelegate", False)
settings.set_bool("/persistent/app/viewport/Viewport/Viewport0/scene/cameras/visible", False)
context = omni.usd.get_context()
assert context.open_stage(str(args.scene.resolve()))
update_for(1.5)
stage = context.get_stage()
assert stage and stage.GetPrimAtPath("/World/SensorCamera")
frames = args.output / "frames"
frames.mkdir()
capture_dataset(stage, frames)
except Exception:
(args.output / "capture-failed").touch()
traceback.print_exc()
raise
finally:
app.close()
preview_dataset.py
GitHub에서 파일 보기"""Preview the real RGB, depth, and semantic ID arrays captured by Replicator."""
import argparse
import json
from pathlib import Path
import subprocess
from tempfile import TemporaryDirectory
from zipfile import ZIP_DEFLATED, ZipFile
import numpy as np
from PIL import Image, ImageDraw, ImageFont
PALETTE = {"target": (125, 222, 133), "distractor": (74, 133, 204),
"occluder": (234, 133, 97), "workbench": (179, 160, 112)}
def font(size):
location = Path("/System/Library/Fonts/Avenir Next.ttc")
return ImageFont.truetype(str(location) if location.exists() else "DejaVuSans.ttf", size)
def panels(frame, row):
rgb = Image.open(frame / "rgb.png").convert("RGB")
depth = np.load(frame / "depth_m.npy", allow_pickle=False)
sid = np.load(frame / "semantic_ids.npy", allow_pickle=False)
labels = json.loads((frame / "semantic_labels.json").read_text())
assert depth.shape == sid.shape == (540, 960)
shade = np.zeros((*depth.shape, 3), np.uint8)
finite = np.isfinite(depth)
ranges = [1.2, 1.9, 2.6, 3.4]
gradient = np.array([(247, 224, 132), (98, 188, 161), (39, 102, 141), (13, 27, 48)])
shade[finite] = np.stack([np.interp(depth[finite], ranges, gradient[:, k]) for k in range(3)], axis=1).astype(np.uint8)
semantic = np.full((*sid.shape, 3), (19, 28, 35), np.uint8)
for serial, label in labels.items():
category = label.get("class") if isinstance(label, dict) else label
semantic[sid == int(serial)] = PALETTE.get(category, (41, 52, 58))
if row["target_bbox_xyxy"] is not None:
drawing = ImageDraw.Draw(rgb)
drawing.rectangle(tuple(row["target_bbox_xyxy"]), outline=(138, 241, 151), width=3)
return rgb, Image.fromarray(shade), Image.fromarray(semantic)
def preview(frame, row, path):
directions = ["RGB + box from semantic pixels", "Camera-plane depth [1.2–3.4 m]", "Semantic mask"]
values = panels(frame, row)
canvas = Image.new("RGB", (1440, 372), (18, 23, 27))
draw = ImageDraw.Draw(canvas)
for i, (image, text) in enumerate(zip(values, directions, strict=True)):
x = 12 + i*480
draw.text((x, 11), text, font=font(19), fill=(229, 239, 236))
canvas.paste(image.resize((456, 256), Image.Resampling.LANCZOS), (x, 43))
explanation = f"FRAME {row['frame']:02d} • CUBE PIXELS {row['target_pixels']:,}"
draw.text((12, 321), explanation, font=font(19), fill=(229, 239, 236))
draw.text((974, 322), "Target • Distractor • Occluder", font=font(17), fill=(153, 205, 167))
canvas.save(path)
def main():
parser = argparse.ArgumentParser(description=__doc__)
parser.add_argument("dataset", type=Path)
args = parser.parse_args()
data = json.loads((args.dataset / "result.json").read_text())
assert len(data["frames"]) == 12
with TemporaryDirectory(prefix="replicator-preview-") as temporary:
root = Path(temporary)
for row in data["frames"]:
i = row["frame"]
preview(args.dataset / "frames" / f"{i:02d}", row, root / f"{i:02d}.png")
(args.dataset / "replicator-sample.png").write_bytes((root / "03.png").read_bytes())
subprocess.run([
"ffmpeg", "-hide_banner", "-loglevel", "error", "-y", "-framerate", "5/3",
"-i", str(root / "%02d.png"), "-vf", "fps=30", "-c:v", "libx264",
"-pix_fmt", "yuv420p", "-movflags", "+faststart", str(args.dataset / "replicator-samples.mp4"),
], check=True)
with ZipFile(args.dataset / "replicator-dataset.zip", "w", compression=ZIP_DEFLATED) as archive:
archive.write(args.dataset / "result.json", "result.json")
for file in sorted((args.dataset / "frames").rglob("*")):
if file.is_file():
archive.write(file, str(file.relative_to(args.dataset)))
if __name__ == "__main__":
main()
check_capture.py
GitHub에서 파일 보기"""Check the recorded RGB, depth and semantic masks against Replicator's manifest."""
import argparse
import hashlib
import json
from pathlib import Path
import numpy as np
from PIL import Image
def check(folder):
report = json.loads((folder / "result.json").read_text())
width, height = report["resolution_px"]
frames = report["frames"]
assert len(frames) == 12
seen = set()
for i, row in enumerate(frames):
assert row["frame"] == i
sample = folder / "frames" / f"{i:02d}"
with Image.open(sample / "rgb.png") as png:
rgb = np.asarray(png.convert("RGB"))
depth = np.load(sample / "depth_m.npy", allow_pickle=False)
ids = np.load(sample / "semantic_ids.npy", allow_pickle=False)
labels = json.loads((sample / "semantic_labels.json").read_text())
assert rgb.shape == (height, width, 3) and ids.shape == depth.shape == (height, width)
digest = hashlib.sha256(rgb.tobytes()).hexdigest()
assert digest == row["rgb_sha256"] and digest not in seen
seen.add(digest)
target_ids = [int(key) for key, value in labels.items()
if (value.get("class") if isinstance(value, dict) else value) == "target"]
mask = np.isin(ids, target_ids)
assert np.count_nonzero(mask) == row["target_pixels"] > 0
assert np.isfinite(depth[mask]).all() and (depth[mask] > 0).all()
print(f"Verified {len(frames)} RGB/depth/semantic triplets at {width}×{height}")
if __name__ == "__main__":
parser = argparse.ArgumentParser(description=__doc__)
parser.add_argument("capture", type=Path)
check(parser.parse_args().capture)