카메라 사진이 어떻게 탐색할 수 있는 공간이 될까요?
- 입력장면 촬영하기
RGB 72장 + K + 4×4 자세 행렬 + 깊이(m)CARLA의 정확한 카메라 정보를 사용합니다. 8번째마다 검사 시점으로 남깁니다.
- 처리공간의 겉모습 학습
학습 사진 63장 → Gaussian 345,318개fVDB가 위치·크기·불투명도·색을 조정합니다. 검사 시점의 깊이는 초기 점군에서 제외합니다.
- 출력새 시점으로 그리기
전체 PLY → MP4 / 345,318개 SPZ → Spark버튼을 누를 때만 브라우저 모델을 받습니다. 물리나 충돌체는 포함되지 않습니다.
아래 3D 화면은 CARLA의 분수 광장을 fVDB Gaussian Splatting으로 실제 복원한 결과입니다. 구에 파노라마를 붙이거나 동영상을 틀어 둔 것이 아닙니다. 내가 선택한 시점에서 3차원 Gaussian을 투영해 새 화면을 그립니다. 버튼을 눌러 회전·이동·확대를 해 보세요. 3D를 지원하지 않는 브라우저에서는 아래 영상을 볼 수 있습니다.
사진, 카메라 정보, 깊이의 역할
640 × 360 RGB 이미지 72장과 카메라 내부 파라미터 K, 월드→카메라 변환 행렬, 미터 단위 깊이를 촬영했습니다. 수평 화각은 80°이며 fx = fy ≈ 381.36px입니다. 픽셀의 (u-cx)/fx, (v-cy)/fy와 깊이로 카메라 기준의 3D 점을 구합니다. 여기에 카메라→월드 행렬을 적용하면 서로 다른 사진의 점들을 같은 공간에 놓을 수 있습니다. 시뮬레이터에서 정확한 카메라 자세를 알고 있으므로 COLMAP으로 자세를 추정하는 단계는 없습니다.
{
  "image_path": "view_000.png",
  "width": 640,
  "height": 360,
  "camera_intrinsics": [[381.361, 0, 320], [0, 381.361, 180], [0, 0, 1]],
  "world_to_camera": "4 x 4 matrix; see evidence/cameras.json"
}
읽기 쉽게 반올림한 예시입니다. 실제 카메라 파일에는 전체 값이 들어 있습니다. CARLA의 왼손 좌표계를 오른손 좌표계로 바꾸기 위해 월드 Y축을 반전하고, 카메라 축을 OpenCV의 오른쪽·아래쪽·전방 기준으로 맞췄습니다. 이 부호를 잘못 바꾸면 공간이 거울처럼 뒤집힙니다.
view_000.png의 중앙 픽셀 (320,180)을 직접 읽으면 깊이는 21.237m입니다. 카메라 기준으로 약 [0,0,21.237]m이고, 저장한 카메라 자세를 적용하면 월드 좌표 [0.958,0,2.131]m가 됩니다. 실제 샘플에 전체 값을 넣었으며 check.py가 이 변환을 다시 계산합니다.
Gaussian 하나에는 무엇이 들어 있을까요?
중심 좌표 [x,y,z], 세 축의 크기, 회전 쿼터니언, 불투명도, 색 계수를 저장합니다. 공간에 놓인 부드러운 타원체라고 생각하면 됩니다. fVDB가 이 타원체들을 화면에 투영하고 겹쳐 그린 뒤 학습 사진과 비교합니다. 오차가 줄어드는 방향으로 값을 조정하고, 필요한 곳에는 Gaussian을 늘리거나 지웁니다. 이번 전체 모델에는 345,318개가 들어 있습니다. fVDB Reality Capture
브라우저용 SPZ에는 Gaussian 345,318개를 모두 유지하고 값을 양자화했습니다. 색 계수는 1차까지만 담아 용량을 6.15MB로 줄였습니다. 녹화 영상은 시선 방향에 따른 색을 표현하는 3차 spherical harmonics 계수까지 포함한 전체 모델로 렌더링했습니다. 따라서 브라우저 미리보기와 영상의 색·밀도에는 차이가 있을 수 있습니다. 이 표현은 장면의 겉모습을 담습니다. 충돌 면, 질량, 로봇 제어는 별도로 구성해야 합니다.
새로운 세계를 생성한 것과는 무엇이 다를까요?
이 실습은 주어진 장면을 복원합니다. 프롬프트로 보이지 않던 골목을 만들어 내지는 않습니다. World Labs Marble과 NVIDIA Lyra는 생성형 3D 세계를, Infinigen은 규칙으로 조합한 실제 기하 구조를 다룹니다. 3D 세계 도구 비교에서 출력 형식과 실행 조건을 나누어 볼 수 있습니다.
아래의 추가 영상 두 개는 CARLA 사진 한 장씩을 Apple SHARP에 넣은 결과입니다. EXIF 추측 대신 실제 90° 카메라의 내부 파라미터를 사용했습니다. 이미지마다 Gaussian 1,179,648개를 예측하고 fVDB로 주변 시점을 그렸습니다. 물체 뒷면까지 복원하거나 완전한 360° 세계를 만든 결과는 아닙니다. 모델 가중치는 비상업적 연구용이며 코드 라이선스와 다릅니다.
처음이면 실습 파일부터 받기
GPU 실습은 Isaac Sim을 실행할 머신에서 터미널을 엽니다. CPU 실습은 지금 쓰는 컴퓨터에서 해도 됩니다. 아래 명령은 한 줄씩 입력하고 Enter를 누르세요. 여러 줄짜리 명령 블록은 통째로 복사해도 됩니다.
cd "$HOME"
git clone https://github.com/james-joobs/awesome-nvidia-physical-ai.git
cd awesome-nvidia-physical-ai
pwd
홈 폴더에 받는 예입니다. 이미 내려받았다면 git clone은 건너뛰고 내 실습 폴더로 이동합니다. 새 터미널을 열 때마다 pwd의 출력 끝이 awesome-nvidia-physical-ai인지 확인하세요. 그래야 labs/로 시작하는 파일을 찾을 수 있습니다.
새로운 장면을 촬영하고 복원하기
1. 여러 시점 촬영하기
CARLA 실습의 설치 순서를 따라 터미널 A에 0.9.16 서버를 띄웁니다. 터미널 B에서는 CARLA용 Python 환경을 활성화하고 저장소 폴더에서 실행하세요.
python labs/spatial-reconstruction/capture.py --output runs/plaza-input
RGB와 깊이 센서가 Town03 광장 주변을 이동합니다. Saved view 72/72가 나오면 촬영이 끝납니다. images/에는 색 PNG, depth/에는 미터 단위 NumPy 배열, cameras.json에는 촬영 당시의 정확한 카메라 자세가 저장됩니다. prepare_seed.py는 초기 점군을 만들 때 검사용으로 남겨 둔 이미지와 그 깊이·색을 사용하지 않습니다. 0,8,16,…번이 검사 대상입니다.
다음 GPU 작업을 시작하기 전에 직접 띄운 CARLA 컨테이너를 종료하세요. CARLA와 fVDB의 Python 환경은 별도로 준비합니다.
2. Gaussian 학습하기
GPU에 맞는 PyTorch·CUDA 조합으로 공식 설치 가이드를 따라 fVDB와 fVDB Reality Capture를 설치합니다. 해당 환경에서 plyfile, Pillow, SciPy도 준비하세요. 검증한 환경은 RTX 5090, fVDB 0.6.0, PyTorch 2.13.0+cu130입니다. 정확한 실행 정보는 recorded.json에 남겼습니다.
python labs/spatial-reconstruction/reconstruct.py \
  --input runs/plaza-input --output runs/plaza-3dgs --ffmpeg ffmpeg
카메라 자세를 고정한 채 RGB 63장으로 40에포크를 학습합니다. 전체 PLY와 가벼운 .splat을 저장하고, 새 카메라 경로의 영상과 검사 지표를 만듭니다. 촬영 환경에서는 cuDNN 라이브러리 버전 충돌이 있어 cuDNN을 끄고 PyTorch의 기본 CUDA 합성곱을 사용했습니다. fVDB 학습·렌더링은 계속 GPU에서 수행합니다. 코드와 실행 기록에도 이 우회 설정을 명시했습니다.
브라우저용 모델은 Gaussian을 버리지 않고 전체 PLY를 PlayCanvas CLI로 압축합니다.
python3 labs/spatial-reconstruction/compress_web.py runs/plaza-3dgs/town03.ply runs/plaza-3dgs/town03.spz
3. 사진 한 장으로도 비교하기
선택 실습입니다. SHARP와 의존성을 fVDB도 불러올 수 있는 환경에 설치합니다. 연구용 모델 라이선스를 확인한 뒤 공식 체크포인트를 받으세요. 앞서 찍은 CARLA 운전자 JPEG들을 runs/sharp-input/에 넣고 실행합니다.
python labs/spatial-reconstruction/reconstruct_single.py \
  --input runs/sharp-input --output runs/sharp-output \
  --checkpoint /path/to/sharp_2572gikvuh.pt --ffmpeg ffmpeg
이 코드는 이번 CARLA의 90° 카메라를 가정합니다. 다른 사진에는 해당 초점거리를 사용해야 합니다. 좌우 ±0.35m 범위로 시점을 움직입니다. 크게 이동하면 입력에서 보지 못한 빈 공간이 드러납니다.
GPU 없이 결과 검사하기
python3 labs/spatial-reconstruction/check.py
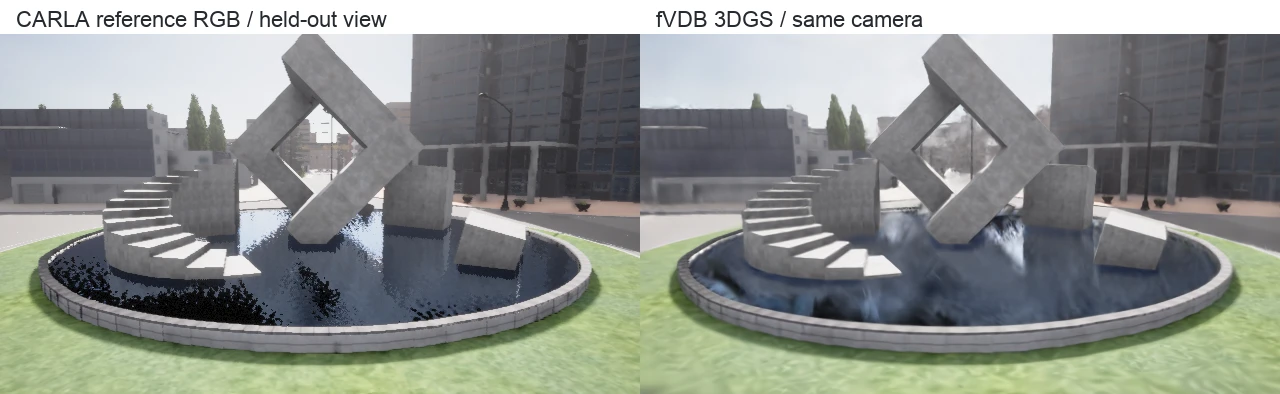
검사용으로 남긴 시점, 카메라 회전, 모델 값의 유효성, 미리보기 용량과 영상 해시를 확인합니다. 이번 실행 기록의 검사 이미지 9장은 평균 PSNR 23.434dB입니다. 학습에 이 RGB들을 넣지 않았고 초기 점군에도 해당 깊이·색을 넣지 않았습니다. 작은 합성 장면에서 측정한 값이며, 여러 데이터셋을 비교한 성능 순위는 아닙니다. 물결, 먼 배경, 촬영 범위 바깥은 여전히 번지거나 비어 보일 수 있습니다.
저장소에는 코드·카메라 정보·지표·압축 영상·브라우저용 모델을 넣었습니다. 미디어 출처와 이용 조건 · 실내 장면 생성하기 · fVDB 동작 원리.
직접 시점을 움직여 보기
CARLA에서 촬영한 광장을 fVDB로 복원했습니다. 버튼을 누를 때만 3D 데이터와 뷰어를 불러옵니다. 물리·충돌은 포함되지 않습니다.
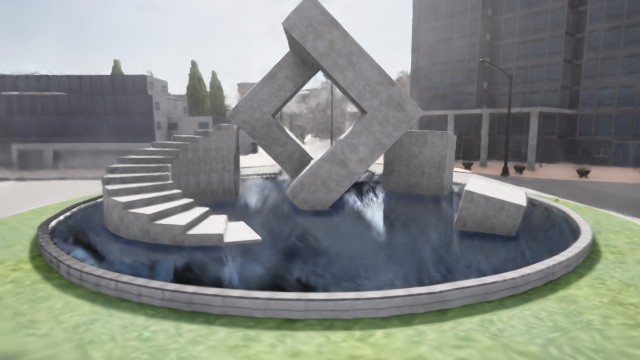
드래그: 회전 · 휠/두 손가락: 확대·축소 · 오른쪽 드래그: 이동. 화면에 포커스를 두면 W/A/S/D로도 이동합니다. 빈 영역과 번진 물결은 복원 결과의 한계입니다.
SPZ로 압축해 Gaussian 345,318개를 모두 유지했습니다. 웹 색 계수는 1차, 아래 영상과 PSNR은 3차 전체 모델 기준입니다. Spark / World Labs (MIT) · CARLA assets / CC-BY
실행 영상과 기록
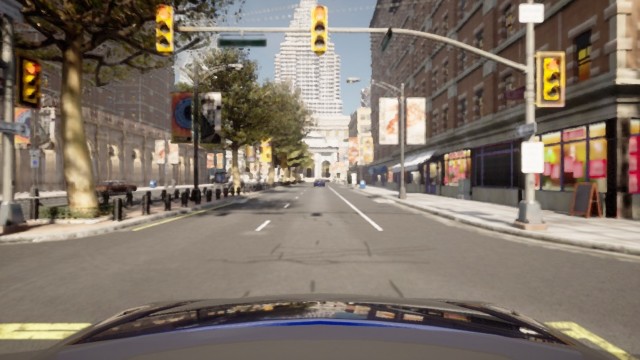
사진 한 장에서 복원한 주택가
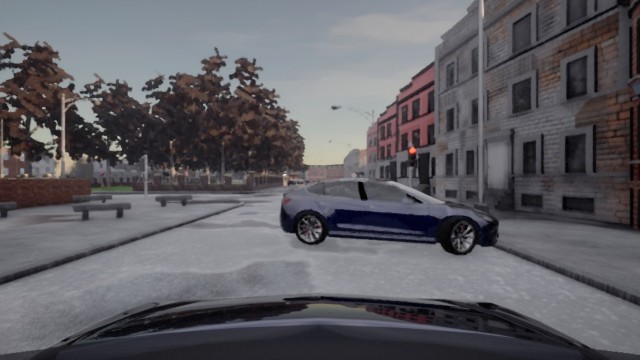
CARLA 사진을 SHARP에 넣고 fVDB로 주변 시점을 렌더링했습니다. 연구용 가중치를 사용한 단일 시점 복원이며 완전한 360° 공간은 아닙니다.
실습 소스 코드
capture.py
GitHub에서 파일 보기"""Capture a static CARLA neighborhood with known cameras for fVDB reconstruction.
This is a measured RGB-D dataset, not a generated world or an SfM estimate.
"""
import argparse
import json
import math
import queue
from pathlib import Path
import carla
import numpy as np
from PIL import Image
from prepare_seed import prepare
def read_frame(q, frame):
while True:
image = q.get(timeout=30)
if image.frame == frame:
return np.frombuffer(image.raw_data, np.uint8).reshape(image.height, image.width, 4).copy()
if image.frame > frame:
raise RuntimeError("Camera timestamps do not match")
def main():
parser = argparse.ArgumentParser()
parser.add_argument("--output", required=True, type=Path)
parser.add_argument("--port", type=int, default=24000)
parser.add_argument("--views", type=int, default=72)
args = parser.parse_args()
output = args.output
(output / "images").mkdir(parents=True, exist_ok=True)
(output / "depth").mkdir(exist_ok=True)
client = carla.Client("127.0.0.1", args.port)
client.set_timeout(90)
world = client.load_world("Town03")
previous = world.get_settings()
settings = world.get_settings()
settings.synchronous_mode = True
settings.fixed_delta_seconds = .05
world.apply_settings(settings)
world.set_weather(carla.WeatherParameters.ClearNoon)
width, height, fov = 640, 360, 80
focal = width / (2*math.tan(math.radians(fov/2)))
intrinsics = np.array([[focal,0,width/2],[0,focal,height/2],[0,0,1]])
sensors = []
cameras = []
# Reflect the world Y axis to make a right-handed reconstruction world.
world_basis = np.diag([1.,-1.,1.,1.])
camera_basis = np.array([[0,0,1,0],[1,0,0,0],[0,-1,0,0],[0,0,0,1.]])
try:
for kind in ("rgb", "depth"):
bp = world.get_blueprint_library().find(f"sensor.camera.{kind}")
for key,value in {"image_size_x":width,"image_size_y":height,"fov":fov,"sensor_tick":0}.items():
bp.set_attribute(key,str(value))
if kind == "rgb":
bp.set_attribute("motion_blur_intensity","0")
sensor = world.spawn_actor(bp, carla.Transform())
q=queue.Queue()
sensor.listen(q.put)
sensors.append((sensor,q))
for i in range(args.views):
# Two interleaved rings; every eighth pose is held out during training.
angle=2*math.pi*i/args.views
radius=22+2*math.sin(3*angle)
x,y=radius*math.cos(angle),radius*math.sin(angle)
z=5+2*math.sin(2*angle)
yaw=math.degrees(math.atan2(-y,-x))
pitch=math.degrees(math.atan2(2-z, radius))
transform=carla.Transform(carla.Location(x=x,y=y,z=z),carla.Rotation(pitch=pitch,yaw=yaw))
for sensor,_ in sensors:
sensor.set_transform(transform)
for _ in range(6):
frame=world.tick()
data=[read_frame(q,frame) for _,q in sensors]
rgb=data[0][:,:,:3][:,:,::-1].copy()
raw=data[1].astype(np.float64)
depth=(raw[:,:,2]+raw[:,:,1]*256+raw[:,:,0]*65536)/16777215*1000
name=f"view_{i:03}.png"
Image.fromarray(rgb).save(output/"images"/name)
np.save(output/"depth"/f"view_{i:03}.npy",depth.astype(np.float32))
c2w=world_basis@np.array(transform.get_matrix())@camera_basis
assert np.isclose(np.linalg.det(c2w[:3,:3]),1,atol=1e-5)
cameras.append({"camera_name":name,"image_path":name,"width":width,"height":height,
"camera_intrinsics":intrinsics.tolist(),"world_to_camera":np.linalg.inv(c2w).tolist(),
"sensor_frame":frame})
print(f"Saved view {i+1}/{args.views}",flush=True)
(output/"cameras.json").write_text(json.dumps(cameras,indent=2)+"\n")
seed_points=prepare(output)
report={"backend":"CARLA 0.9.16 / Unreal Engine 4.26","map":"Town03","weather":"ClearNoon",
"views":len(cameras),"resolution":[width,height],"fov_degrees":fov,
"seed_points":seed_points,"seed_views":[i for i in range(args.views) if i%3==0 and i%8!=0],"held_out_modulo":8,
"depth":"CARLA RGB24 depth decoded in meters",
"camera_convention":"OpenCV x-right y-down z-forward; right-handed world: CARLA Y reflected",
"source_license":"CARLA-specific assets: CC-BY; see CARLA 0.9.16 README licenses"}
(output/"capture.json").write_text(json.dumps(report,indent=2)+"\n")
finally:
for sensor,_ in sensors:
sensor.stop()
sensor.destroy()
world.apply_settings(previous)
if __name__=="__main__":
main()
prepare_seed.py
GitHub에서 파일 보기"""Seed 3DGS only from training-view depth and colors; reserve indices 0,8,16,..."""
import argparse
import json
from pathlib import Path
import numpy as np
from PIL import Image
def prepare(folder):
cameras=json.loads((folder/"cameras.json").read_text())
clouds,colors=[],[]
for i,camera in enumerate(cameras):
if i%3 or i%8==0:
continue
rgb=np.array(Image.open(folder/"images"/camera["image_path"]).convert("RGB"))
depth=np.load(folder/"depth"/f"view_{i:03}.npy")
h,w=depth.shape
K=np.array(camera["camera_intrinsics"])
c2w=np.linalg.inv(camera["world_to_camera"])
v,u=np.mgrid[0:h:6,0:w:6]
d=depth[v,u]
good=(d>.5)&(d<80)
cv=np.stack([(u-K[0,2])/K[0,0]*d,(v-K[1,2])/K[1,1]*d,d],-1)[good]
clouds.append(cv@c2w[:3,:3].T+c2w[:3,3])
colors.append(rgb[v,u][good])
xyz,rgb=np.concatenate(clouds),np.concatenate(colors)
_,indices=np.unique(np.floor(xyz/.12).astype(int),axis=0,return_index=True)
xyz,rgb=xyz[indices],rgb[indices]
with (folder/"pointcloud.ply").open("w") as f:
f.write("ply\nformat ascii 1.0\nelement vertex %d\n"%len(xyz))
f.write("property float x\nproperty float y\nproperty float z\nproperty uchar red\nproperty uchar green\nproperty uchar blue\nend_header\n")
for p,c in zip(xyz,rgb):
f.write("%.5f %.5f %.5f %d %d %d\n"%(*p,*c))
return len(xyz)
if __name__=="__main__":
parser=argparse.ArgumentParser()
parser.add_argument("folder",type=Path)
args=parser.parse_args()
count=prepare(args.folder)
report=json.loads((args.folder/"capture.json").read_text())
report.update(seed_points=count,seed_views=[i for i in range(len(json.loads((args.folder/"cameras.json").read_text()))) if i%3==0 and i%8!=0],held_out_modulo=8)
(args.folder/"capture.json").write_text(json.dumps(report,indent=2)+"\n")
print(f"Seeded {count} points; held-out RGB and depth excluded.")
reconstruct.py
GitHub에서 파일 보기"""Train an fVDB 3DGS scene from known CARLA cameras; hold out every eighth image."""
import argparse
import hashlib
import json
import math
import subprocess
import time
from pathlib import Path
import fvdb
import numpy as np
import torch
from PIL import Image
from plyfile import PlyData
from scipy.spatial.transform import Rotation, Slerp
from fvdb_reality_capture.radiance_fields import GaussianSplatReconstruction, GaussianSplatReconstructionConfig, GaussianSplatOptimizerConfig
from fvdb_reality_capture.sfm_scene import SfmScene
from fvdb_reality_capture.sfm_scene.sfm_scene import SpatialScaleMode
def export_browser_splat(source, target, maximum=200_000):
"""32-byte .splat, DC color only, deterministic opacity-weighted subset.
Browser preview is deliberately smaller than the original SH-degree-3 model.
"""
vertices = PlyData.read(source)["vertex"].data
opacity = 1/(1+np.exp(-np.clip(vertices["opacity"],-40,40)))
valid = np.flatnonzero(opacity>.04)
if len(valid)>maximum:
rng=np.random.default_rng(42)
weights=opacity[valid].astype(np.float64)
valid=np.sort(rng.choice(valid,maximum,replace=False,p=weights/weights.sum()))
v=vertices[valid]
packed=np.empty(len(v),dtype=[("position","<f4",3),("scale","<f4",3),("rgba","u1",4),("rotation","u1",4)])
packed["position"]=np.stack([v[k] for k in ("x","y","z")],-1)
packed["scale"]=np.exp(np.stack([v[f"scale_{i}"] for i in range(3)],-1))
color=.5+.28209479177387814*np.stack([v[f"f_dc_{i}"] for i in range(3)],-1)
packed["rgba"][:,:3]=np.clip(color*255,0,255).astype(np.uint8)
packed["rgba"][:,3]=np.clip(opacity[valid]*255,0,255).astype(np.uint8)
quat=np.stack([v[f"rot_{i}"] for i in range(4)],-1)
quat/=np.linalg.norm(quat,axis=1,keepdims=True).clip(1e-8)
packed["rotation"]=np.clip(quat*128+128,0,255).astype(np.uint8)
packed.tofile(target)
return {"gaussians":len(v),"bytes":target.stat().st_size,"sha256":hashlib.sha256(target.read_bytes()).hexdigest(),
"format":"32-byte .splat; DC color; opacity > .04; deterministic weighted sampling if needed"}
def main():
parser=argparse.ArgumentParser()
parser.add_argument("--input",type=Path,required=True)
parser.add_argument("--output",type=Path,required=True)
parser.add_argument("--epochs",type=int,default=40)
parser.add_argument("--ffmpeg",default="ffmpeg")
args=parser.parse_args()
args.output.mkdir(parents=True,exist_ok=True)
torch.backends.cudnn.enabled=False # GPU workstation cuDNN library mismatch; native CUDA convolutions still work.
scene=SfmScene.from_simple_directory(args.input)
config=GaussianSplatReconstructionConfig(max_epochs=args.epochs,optimize_camera_poses=False,
refine_stop_epoch=args.epochs,near_plane=.05,far_plane=200)
optimizer=GaussianSplatOptimizerConfig(spatial_scale_mode=SpatialScaleMode.MAX_CAMERA_TO_CENTROID,max_gaussians=750_000)
runner=GaussianSplatReconstruction.from_sfm_scene(scene,config=config,optimizer_config=optimizer,use_every_n_as_val=8)
start=time.monotonic()
runner.optimize()
seconds=time.monotonic()-start
model=runner.model
model_path=args.output/"town03.ply"
runner.save_ply(model_path)
browser=export_browser_splat(model_path,args.output/"town03.splat")
width,height=640,360
K=np.array(scene.images[0].camera_metadata.projection_matrix,dtype=np.float32)
def render(c2w):
with torch.inference_mode():
rgb,alpha=model.render_images(torch.tensor(np.linalg.inv(c2w)[None],dtype=torch.float32,device="cuda"),
torch.tensor(K[None],dtype=torch.float32,device="cuda"),width,height,.05,200)
return rgb[0,:,:,:3].clamp(0,1).cpu().numpy(),float(alpha.mean())
metrics=[]
for i in range(0,len(scene.images),8):
pred,alpha=render(scene.camera_to_world_matrices[i])
ref=np.array(Image.open(scene.images[i].image_path).convert("RGB"))/255
mse=np.mean((pred-ref)**2)
metrics.append({"view":i,"psnr_db":round(-10*math.log10(max(float(mse),1e-12)),3),"mean_alpha":round(alpha,4)})
if i==0:
Image.fromarray((pred*255).astype(np.uint8)).save(args.output/"held-out-render.png")
Image.fromarray((ref*255).astype(np.uint8)).save(args.output/"held-out-reference.png")
poses=scene.camera_to_world_matrices
keys=np.arange(len(poses)+1,dtype=float)
closed=np.concatenate([poses,poses[:1]],axis=0)
rotations=Slerp(keys,Rotation.from_matrix(closed[:,:3,:3]))
fps,frames=24,384
movie=args.output/"flythrough.mp4"
encoder=subprocess.Popen([args.ffmpeg,"-hide_banner","-loglevel","error","-y","-f","rawvideo","-pix_fmt","rgb24",
"-s",f"{width}x{height}","-r",str(fps),"-i","pipe:0","-an","-c:v","libx264","-crf","22",
"-pix_fmt","yuv420p","-movflags","+faststart",str(movie)],stdin=subprocess.PIPE)
alphas=[]
for t in np.linspace(0,len(poses),frames,endpoint=False):
pose=np.eye(4)
pose[:3,:3]=rotations(float(t)).as_matrix()
pose[:3,3]=[np.interp(t,keys,closed[:,axis,3]) for axis in range(3)]
rgb,alpha=render(pose)
alphas.append(alpha)
encoder.stdin.write((rgb*255).astype(np.uint8).tobytes())
encoder.stdin.close()
assert encoder.wait()==0
report={"mode":"multi-view reconstruction, not generative world-model inference",
"input":json.loads((args.input/"capture.json").read_text()),"input_views":len(poses),
"training_views":len(poses)-len(metrics),"held_out_views":len(metrics),"epochs":args.epochs,
"optimization_seconds":round(seconds,3),"gaussians":int(model.num_gaussians),
"held_out_psnr_db":round(float(np.mean([m["psnr_db"] for m in metrics])),3),"per_view":metrics,
"runtime":{"fvdb":fvdb.__version__,"torch":torch.__version__,"gpu":torch.cuda.get_device_name(0),"cudnn_enabled":False},
"browser":browser,"render":{"frames":frames,"fps":fps,"resolution":[width,height],
"median_alpha":float(np.median(alphas)),"sha256":hashlib.sha256(movie.read_bytes()).hexdigest()},
"limitations":["Static radiance field; no collision mesh or dynamic traffic", "CARLA water and distant sky are difficult to reconstruct", "Intermediate .splat uses sampled DC-only data; use compress_web.py on the full PLY for the published SPZ"]}
(args.output/"result.json").write_text(json.dumps(report,indent=2)+"\n")
print(json.dumps(report,indent=2),flush=True)
if __name__=="__main__":
main()
reconstruct_single.py
GitHub에서 파일 보기"""Run SHARP on our CARLA inputs, using the known 90-degree camera intrinsics.
SHARP weights are research-only. This predicts nearby views, not a complete 360 world.
"""
import argparse
import hashlib
import json
import math
import subprocess
import time
from pathlib import Path
import numpy as np
import torch
from PIL import Image
from fvdb_reality_capture import GaussianSplat3d
from sharp.cli.predict import predict_image
from sharp.models import PredictorParams, create_predictor
from sharp.utils.gaussians import save_ply
def main():
parser=argparse.ArgumentParser()
parser.add_argument("--input",type=Path,required=True)
parser.add_argument("--output",type=Path,required=True)
parser.add_argument("--checkpoint",type=Path,required=True)
parser.add_argument("--ffmpeg",default="ffmpeg")
args=parser.parse_args()
args.output.mkdir(parents=True,exist_ok=True)
torch.backends.cudnn.enabled=False
predictor=create_predictor(PredictorParams())
predictor.load_state_dict(torch.load(args.checkpoint,weights_only=True))
predictor.eval().cuda()
reports=[]
for image_path in sorted(args.input.glob("*.jpg")):
image=np.array(Image.open(image_path).convert("RGB"))
height,width=image.shape[:2]
f_px=width/2 # Our CARLA camera has a known horizontal FOV of 90 degrees.
torch.cuda.synchronize()
start=time.monotonic()
with torch.inference_mode():
gaussians=predict_image(predictor,image,f_px,torch.device("cuda"))
torch.cuda.synchronize()
seconds=time.monotonic()-start
ply=args.output/f"{image_path.stem}.ply"
save_ply(gaussians,f_px,(height,width),ply)
del gaussians
splats,_=GaussianSplat3d.from_ply(str(ply))
w,h,fps,frames=640,360,24,192
K=np.array([[f_px*w/width,0,(w-1)/2],[0,f_px*h/height,(h-1)/2],[0,0,1]])
movie=args.output/f"{image_path.stem}.mp4"
encoder=subprocess.Popen([args.ffmpeg,"-hide_banner","-loglevel","error","-y","-f","rawvideo","-pix_fmt","rgb24",
"-s",f"{w}x{h}","-r",str(fps),"-i","pipe:0","-an","-c:v","libx264","-crf","22",
"-pix_fmt","yuv420p","-movflags","+faststart",str(movie)],stdin=subprocess.PIPE)
for i in range(frames):
phase=i/(frames-1)*2*math.pi
eye=np.array([.35*math.sin(phase),0,.1*(1-math.cos(phase))])
forward=np.array([0,0,12])-eye
forward/=np.linalg.norm(forward)
right=np.cross([0,1,0],forward);right/=np.linalg.norm(right)
pose=np.eye(4);pose[:3,:3]=np.stack([right,np.cross(forward,right),forward],axis=1);pose[:3,3]=eye
with torch.inference_mode():
rgb,_=splats.render_images(torch.tensor(np.linalg.inv(pose)[None],dtype=torch.float32,device="cuda"),
torch.tensor(K[None],dtype=torch.float32,device="cuda"),w,h,.01,1000)
rgb=rgb[0,:,:,:3].clamp(0,1).cpu().numpy()
encoder.stdin.write((rgb*255).astype(np.uint8).tobytes())
if i==0:
Image.fromarray((rgb*255).astype(np.uint8)).save(args.output/f"{image_path.stem}.jpg",quality=90)
encoder.stdin.close()
assert encoder.wait()==0
reports.append({"input":image_path.name,"input_sha256":hashlib.sha256(image_path.read_bytes()).hexdigest(),
"input_resolution":[width,height],"focal_px":f_px,"inference_seconds":round(seconds,3),
"gaussians":int(splats.num_gaussians),"video":movie.name,"video_sha256":hashlib.sha256(movie.read_bytes()).hexdigest(),
"frames":frames,"fps":fps,"camera_motion_m":{"x_amplitude":.35,"z_range":[0,.2]}})
del splats
(args.output/"result.json").write_text(json.dumps({"tool":"Apple SHARP","mode":"single-view reconstruction; nearby novel views",
"renderer":"fVDB","weights_license":"Apple ML Research Model License: noncommercial research purposes",
"runtime":{"torch":torch.__version__,"gpu":torch.cuda.get_device_name(0),"cudnn_enabled":False},"cases":reports},indent=2)+"\n")
if __name__=="__main__":
main()
compress_web.py
GitHub에서 파일 보기"""Compress the complete 3DGS PLY for Spark without dropping Gaussians.
Requires Node/npm. Uses a pinned MIT-licensed PlayCanvas CLI; no data is uploaded.
"""
import argparse
import gzip
import hashlib
import json
from pathlib import Path
import struct
import subprocess
def main():
parser=argparse.ArgumentParser()
parser.add_argument("ply",type=Path)
parser.add_argument("output",type=Path)
args=parser.parse_args()
subprocess.run(["npm","exec","--yes","--package=@playcanvas/splat-transform@3.12.0","--","splat-transform",
str(args.ply),"--filter-harmonics","1",str(args.output),"--spz-version","3"],check=True)
data=args.output.read_bytes()
magic,version,count,degree,fractional_bits,flags,reserved=struct.unpack_from("<IIIBBBB",gzip.decompress(data))
report={"file":args.output.name,"format":"SPZ v3","gaussians":count,"sh_degree":degree,"bytes":len(data),
"sha256":hashlib.sha256(data).hexdigest(),"converter":"PlayCanvas splat-transform 3.12.0 (MIT)",
"modification":"Keep all Gaussians; quantize SPZ and retain SH through degree 1; full PLY remains degree 3"}
args.output.with_suffix(".json").write_text(json.dumps(report,indent=2)+"\n")
print(json.dumps(report,indent=2))
if __name__=="__main__":
main()
check.py
GitHub에서 파일 보기"""Inspect 3DGS evidence with Python's standard library; no CUDA or NumPy required."""
import hashlib
import gzip
import json
import math
from pathlib import Path
import struct
def main():
root=Path(__file__).resolve().parents[2]
folder=root/"labs/spatial-reconstruction"
record=json.loads((folder/"recorded.json").read_text())
assert record["input_views"]==record["training_views"]+record["held_out_views"]==72
assert record["held_out_views"]==9
assert all(i%8!=0 for i in record["input"]["seed_views"])
cameras=json.loads((folder/"evidence/cameras.json").read_text())
assert len(cameras)==72
for camera in cameras:
m=camera["world_to_camera"]
assert len(m)==4 and all(len(row)==4 and all(math.isfinite(x) for x in row) for row in m)
det=(m[0][0]*(m[1][1]*m[2][2]-m[1][2]*m[2][1])-m[0][1]*(m[1][0]*m[2][2]-m[1][2]*m[2][0])+m[0][2]*(m[1][0]*m[2][1]-m[1][1]*m[2][0]))
assert math.isclose(det,1,abs_tol=1e-5), "Camera axes are not a right-handed rotation"
sample=json.loads((folder/"evidence/point-sample.json").read_text())
u,v=sample["pixel_uv"];K=sample["intrinsics"];d=sample["depth_m"]
point=[(u-K[0][2])/K[0][0]*d,(v-K[1][2])/K[1][1]*d,d]
assert all(math.isclose(a,b,abs_tol=1e-6) for a,b in zip(point,sample["point_camera_m"]))
m=sample["camera_to_world"]
world=[sum(m[i][j]*point[j] for j in range(3))+m[i][3] for i in range(3)]
assert all(math.isclose(a,b,abs_tol=1e-5) for a,b in zip(world,sample["point_world_m"]))
media=root/"site/public/showcase"
raw=(media/"town03.spz").read_bytes()
assert len(raw)==record["web_preview"]["bytes"]
assert hashlib.sha256(raw).hexdigest()==record["web_preview"]["sha256"]
unpacked=gzip.decompress(raw)
magic,version,count,degree,_,_,_=struct.unpack_from('<IIIBBBB',unpacked)
assert unpacked[:4]==b'NGSP' and version==3 and degree==1
assert count==record["gaussians"]==record["web_preview"]["gaussians"]
assert len(unpacked)==16+count*(20+((degree+1)**2-1)*3), "SPZ payload is incomplete"
assert hashlib.sha256((media/"spatial-reconstruction.mp4").read_bytes()).hexdigest()==record["render"]["sha256"]
sharp=json.loads((folder/"sharp-recorded.json").read_text())
for case in sharp["cases"]:
assert case["gaussians"]==1_179_648 and case["focal_px"]==case["input_resolution"][0]/2
assert hashlib.sha256((media/f'sharp-{case["video"]}').read_bytes()).hexdigest()==case["video_sha256"]
print(f'{record["training_views"]} training / {record["held_out_views"]} held-out views; no held-out depth in seed')
print(f'Full model: {record["gaussians"]:,} Gaussians, held-out PSNR {record["held_out_psnr_db"]} dB')
print(f'Camera transforms, RGB-D sample, {len(raw):,}-byte browser model and 3 videos verified.')
if __name__=="__main__":
main()