글로 묘사한 장소를 어떻게 둘러볼 수 있을까요?
- 입력장소를 글이나 이미지로 지정
프롬프트 / RGB + 카메라 K(3×3) + 생성 마스크글은 파노라마 전체를 만들고, 이미지는 보이는 영역을 유지한 채 주변을 채웁니다.
- 처리겉모습 생성 후 거리 추정
FLUX + 파노라마 LoRA → RGB 1600×800 → DA-2픽셀마다 카메라에서 표면까지의 거리를 추정합니다. 최댓값 20은 정규화 값이며 실측 미터가 아닙니다.
- 출력3D 데이터로 바꿔 다른 시점에서 보기
Gaussian 128만 개 + 메시 → PLY / SPZ / MP4단위 광선 × 거리로 XYZ를 구합니다. 카메라를 옮기면 시차와 가려진 면의 한계가 드러납니다.
WorldGen은 먼저 360° 공간의 겉모습을 이미지로 생성하고, 카메라에서 각 표면까지의 거리를 추정합니다. 이 두 배열을 Gaussian 장면과 색이 있는 메시로 바꾸면, 저장된 3D 데이터 안에서 카메라를 움직여 다른 시점을 그릴 수 있습니다. 이번 실습에서는 글로 로봇 실험실을 만들고, 이미지 한 장에서 주변 거실을 확장합니다. 추가로 생성한 숲길에서는 실외 장면의 차이도 확인할 수 있습니다.
1. 겉모습을 만들고, 거리를 추정합니다
텍스트 입력에서는 FLUX.1-dev와 WorldGen의 파노라마 LoRA가 [800, 1600, 3] 형태의 RGB 배열을 생성합니다. 가로축은 360°, 세로축은 180°를 담습니다. 이 단계의 파노라마는 아직 이미지입니다. 각 표면이 3D 공간의 어디에 있는지는 명시되어 있지 않습니다.
DA-2는 파노라마를 읽고 거리 배열 [800, 1600]을 예측합니다. 각 값은 해당 픽셀의 광선을 따라 카메라에서 표면까지 얼마나 떨어져 있는지를 뜻합니다. Replicator 실습의 카메라 평면 기준 Z 깊이와는 다릅니다. WorldGen은 추정 거리의 최댓값이 20이 되도록 맞춥니다. 이 값은 정규화된 추정값이며 실측 미터가 아닙니다.
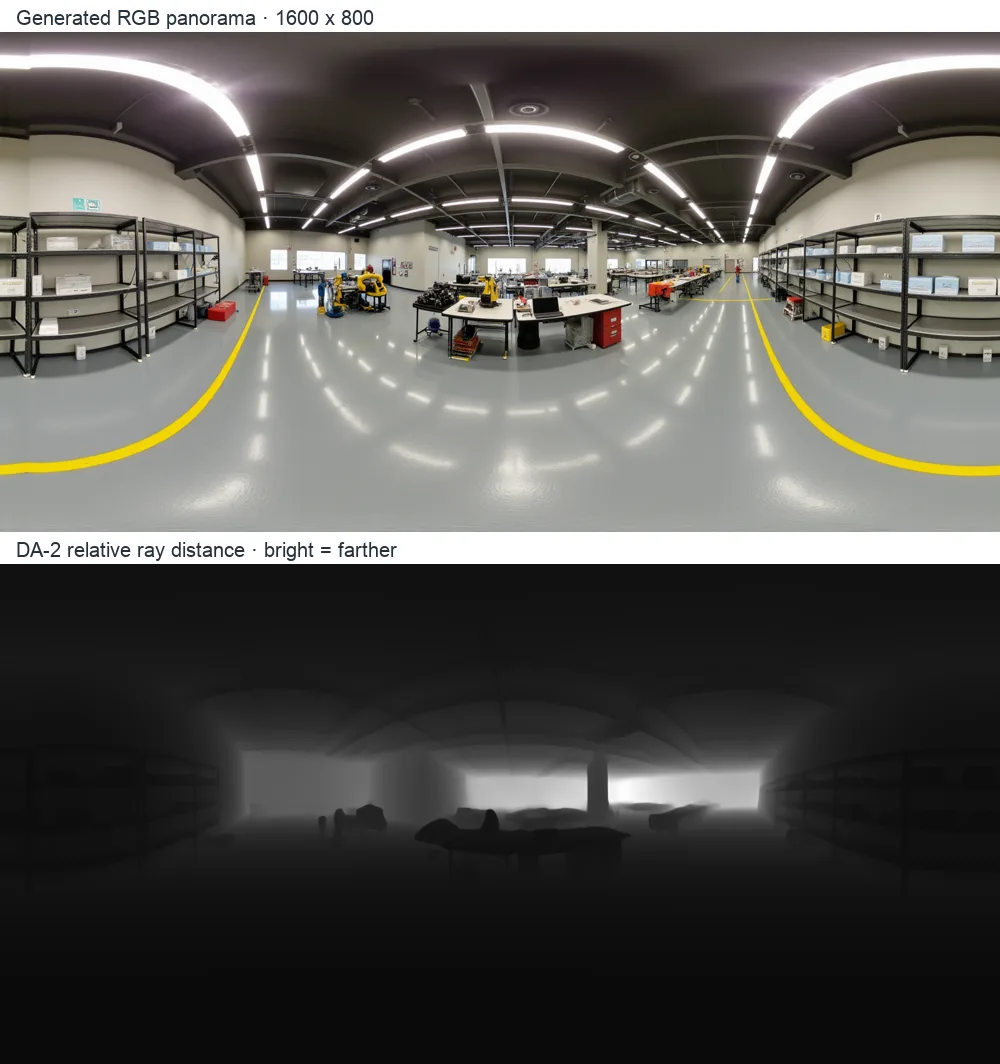
거리 미리보기는 멀다고 추정한 곳일수록 밝게 표시합니다. 모델 출력을 시각화한 것이며 정답 데이터는 아닙니다. 파노라마가 그럴듯해 보여도 책상이 휘거나, 거리가 부정확하거나, 가려진 면이 일관되지 않을 수 있습니다.
2. 픽셀마다 Gaussian을 배치합니다
파노라마의 픽셀 위치로부터 단위 방향 벡터 ray = [x, y, z]를 구한 뒤, 추정 거리를 곱합니다.
XYZ = 단위 광선 × 추정 거리
RGB 픽셀 → Gaussian의 색
픽셀이 차지하는 각도와 거리 → Gaussian의 크기
광선 주변의 좌표축 → 회전 quaternion [w, x, y, z]
카메라 위치는 [0, 0, 0]이며 X는 오른쪽, Y는 아래쪽, Z는 앞쪽입니다. 전체 장면은 파노라마 픽셀당 하나씩 Gaussian 128만 개로 이루어집니다. 각각 위치·크기·회전·불투명도·색을 가집니다. PLY 파일에는 크기의 로그값과 불투명도의 logit 값을 저장하므로 읽는 쪽에서 이를 복원해야 합니다. 제공하는 내보내기 코드는 원본의 불투명도 저장 방식을 바로잡고 극점의 0 크기를 제한합니다. 모델을 새로 학습한 것은 아닙니다.
메시는 역투영한 이웃 픽셀을 삼각형으로 연결한 것입니다. 표면을 추정해 만든 껍질에 가깝습니다. 가구마다 따로 모델링했거나 관절이 설정된 장면은 아닙니다.
실제로 생성한 실험실의 픽셀 하나를 보면 아래와 같습니다. 읽기 쉽게 반올림했고 검사 파일에는 원래 정밀도로 남겼습니다. 거의 정면을 향하는 광선이므로 Gaussian은 주로 +Z 방향에 놓입니다. 거리는 WorldGen의 정규화 단위입니다.
{
  "pixel": [
    800,
    400
  ],
  "rgb": [
    179,
    175,
    163
  ],
  "ray": [
    0.001963,
    0.001963,
    0.999996
  ],
  "distance": 7.208282,
  "xyz": [
    0.014154,
    0.014153,
    7.208254
  ]
}
3. 이미지 입력에서는 무엇을 유지하고 무엇을 만들까요?
이번 입력은 실제 사진이 아니라 직접 생성한 Infinigen 실내 렌더입니다. 촬영에 사용한 pinhole 카메라 정보도 함께 저장했습니다.
{
  "resolution": [640, 360],
  "K": [[160, 0, 320], [0, 160, 180], [0, 0, 1]]
}
fx=fy=160은 시야각에 영향을 주는 초점거리 성분이고, (cx,cy)=(320,180)은 주점입니다. 제공하는 보정 코드는 파노라마의 광선을 이 카메라에 투영합니다. 마스크가 검정(0)인 곳은 입력 RGB를 유지하고, 흰색(255)인 곳은 새로 생성하도록 FLUX.1-Fill-dev와 WorldGen 이미지 LoRA에 전달합니다. 생성 후 관측 영역의 픽셀을 다시 합성해 정확히 유지합니다. 여기서 유지되는 대상은 투영·bilinear 보간을 거친 파노라마 픽셀입니다. 원본 카메라의 모든 픽셀을 무손실로 보관한다는 뜻은 아닙니다.
이번 실행에서는 파노라마 픽셀의 **16.30%**를 입력 이미지에서 가져오고 나머지 **83.70%**를 생성했습니다. 유지 영역의 저장된 RGB 오차는 0입니다.
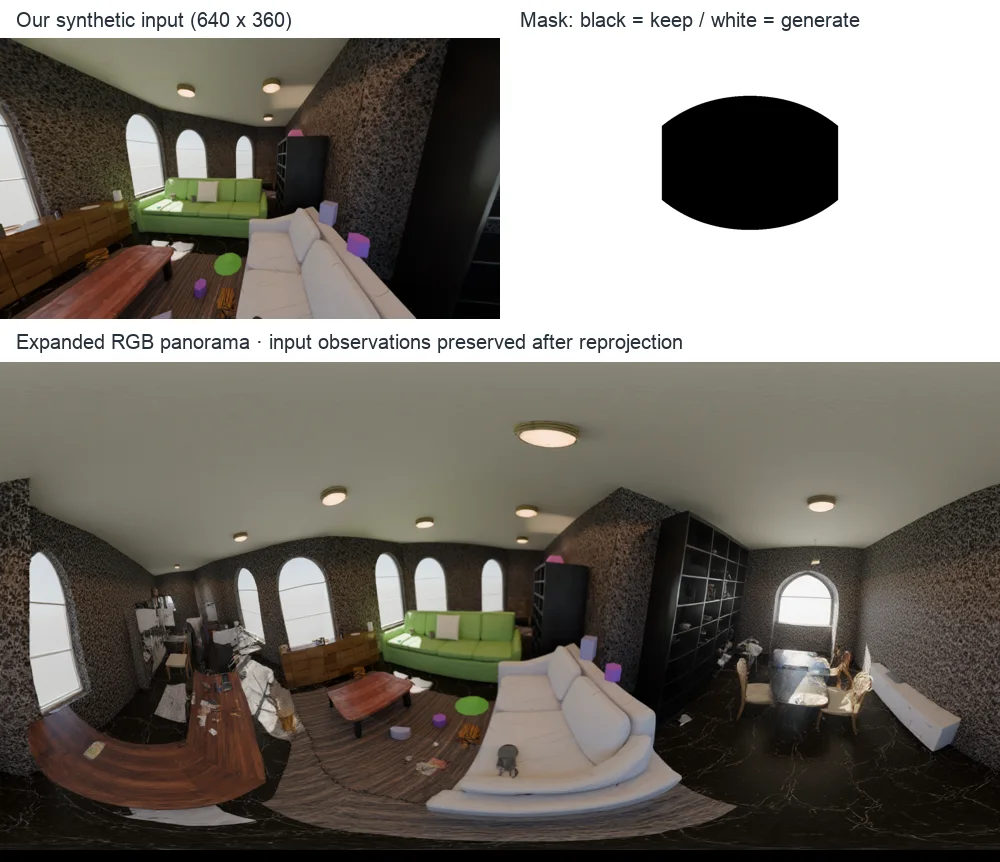
이 보정은 원본의 일반 이미지→파노라마 매핑 부분을 대체합니다. FLUX 파노라마 생성, DA-2, WorldGen의 3D 변환은 원본 구현을 사용합니다. 새로 채운 영역은 모델의 창작입니다. RGB를 유지해도 DA-2가 원래 물체의 형상을 정확히 추정한다는 보장은 없습니다.
처음이면 실습 파일부터 받기
GPU 실습은 Isaac Sim을 실행할 머신에서 터미널을 엽니다. CPU 실습은 지금 쓰는 컴퓨터에서 해도 됩니다. 아래 명령은 한 줄씩 입력하고 Enter를 누르세요. 여러 줄짜리 명령 블록은 통째로 복사해도 됩니다.
cd "$HOME"
git clone https://github.com/james-joobs/awesome-nvidia-physical-ai.git
cd awesome-nvidia-physical-ai
pwd
홈 폴더에 받는 예입니다. 이미 내려받았다면 git clone은 건너뛰고 내 실습 폴더로 이동합니다. 새 터미널을 열 때마다 pwd의 출력 끝이 awesome-nvidia-physical-ai인지 확인하세요. 그래야 labs/로 시작하는 파일을 찾을 수 있습니다.
설치부터 새 장면 생성까지 따라 하기
1. 별도 Linux 환경을 준비합니다
이 저장소의 최상위 폴더에서 시작합니다. NVIDIA 드라이버가 설치된 GPU 머신과 Git, uv가 필요합니다. 먼저 터미널에 nvidia-smi를 입력해 GPU 이름이 오류 없이 나오는지 확인하세요. 이번 실행 환경은 RTX 5090 32GB, 시스템 메모리 30GiB입니다. 환경·모델·결과 파일을 위해 디스크 약 100GB를 확보하세요. 아래 FP4 구성은 Linux x86_64와 이 Blackwell 환경에서 실행했습니다. 다른 아키텍처에서는 맞는 Nunchaku 빌드가 필요합니다.
bash labs/worldgen-scenes/setup.sh runs/worldgen-runtime
runs/worldgen-runtime/.venv/bin/hf auth login
첫 줄은 Python 3.11, PyTorch 2.7/cu128, Nunchaku 0.2와 고정된 WorldGen·DA-2 소스를 별도 폴더에 설치합니다. Isaac Sim의 Python에 설치하지 않습니다. 두 번째 줄은 Hugging Face 로그인을 로컬에 저장합니다. 토큰을 스크립트에 적거나 커밋하지 마세요. 모델을 받기 전에 같은 계정으로 FLUX.1-dev와 FLUX.1-Fill-dev 두 모델 모두 이용 조건·접근 승인을 마쳐야 합니다.
메모리 사용량을 줄이기 위해 Nunchaku FP4와 CPU offload를 사용합니다. RTX 5090에서 실행되지 않는 구형 xFormers 커널 대신 DA-2에 포함된 PyTorch SDPA 경로를 선택했습니다. PyTorch3D는 네이티브 확장 없이 설치합니다. 이 실습에서는 순수 PyTorch로 구현된 quaternion 변환만 사용하며, PyTorch3D 네이티브 래스터라이저는 사용할 수 없습니다. 소스와 모델의 고정 버전은 model-pins.json에 있습니다.
2. 글로 장소를 생성합니다
아래 블록 전체를 저장소 최상위 폴더의 터미널에 붙여 넣으세요. 줄 끝의 \는 다음 줄까지 하나의 명령이라는 뜻입니다. 마지막 JSON 메시지가 나올 때까지 기다립니다.
runs/worldgen-runtime/.venv/bin/python labs/worldgen-scenes/generate.py \
  --output runs/worldgen/robot-lab --seed 42 \
  --prompt "A spacious realistic robotics laboratory with collaborative robot arms on workbenches, yellow safety markings on a polished concrete floor, metal storage racks, large windows, natural daylight, no people, a coherent modern industrial interior"
처음에는 고정 버전의 모델을 내려받습니다. 다음 실행부터는 캐시를 재사용합니다. panorama.png가 먼저 생긴 뒤 distance.npy, scene.ply, scene-mesh.ply, scene-mesh.glb, result.json이 저장됩니다. 이미지가 나왔다고 3D 변환까지 성공한 것은 아닙니다. 마지막 결과 파일도 확인하세요. 이 머신에서 로봇 실험실 생성에 걸린 시간은 캐시 다운로드 이후 모델 로딩을 포함해 약 44초였습니다. 한 번의 실행 기록이며 하드웨어 성능 비교 수치는 아닙니다.
3. 이미지 주변을 확장합니다
실행에 사용한 입력 이미지와 카메라 정보를 저장소에 넣었습니다. 카메라 파일의 해상도는 이미지와 같아야 합니다. 다른 사진에는 그 카메라에 맞는 내부 파라미터가 필요합니다. 아래 값을 그대로 재사용하지 마세요.
runs/worldgen-runtime/.venv/bin/python labs/worldgen-scenes/generate.py \
  --output runs/worldgen/livingroom \
  --image labs/worldgen-scenes/evidence/input.png \
  --intrinsics labs/worldgen-scenes/evidence/input-camera.json \
  --prompt "A coherent spacious living room continuing the input image, matching the pale walls, wooden furniture, indoor materials and natural window light, realistic interior, no people"
결과를 평가하기 전에 generation-mask.png와 conditioning.png를 열어보세요. 입력에서 가져온 부분과 모델이 채운 부분을 구분할 수 있습니다. 실외 예제도 해보고 싶다면 이미지 인자를 빼고, recorded.json의 숲길 프롬프트와 시드 17을 사용하세요.
4. 카메라 위치를 옮겨 렌더링합니다
렌더링에는 **호환되는 별도 fVDB Reality Capture 환경**을 사용합니다. WorldGen의 Torch 2.7 환경에 추가하지 마세요. 아래 경로는 그 별도 Python을 가리키는 예시입니다. 먼저 이 환경에서 fvdb_reality_capture를 import할 수 있어야 하고 ffmpeg도 필요합니다.
runs/fvdb-runtime/bin/python labs/worldgen-scenes/render.py \
  --scene runs/worldgen/robot-lab/scene.ply \
  --output runs/worldgen/robot-lab/render --ffmpeg ffmpeg
480프레임을 24 FPS로 저장한 20초 MP4와 카메라 행렬 cameras.json이 생깁니다. 카메라는 360° 회전하면서 X/Y/Z 방향으로 각각 총 0.4 / 0.09 / 0.3만큼 위치도 바뀝니다. 평면 파노라마를 잘라 움직인 것이 아니라 3D PLY를 새 시점에서 그린 영상입니다. 가려졌던 면을 정확히 알 수 없으므로 원래 시점 가까이에서 움직입니다. 아래 세 영상은 전체 Gaussian을 사용했습니다. 브라우저 미리보기는 다운로드를 줄이기 위해 네 개 중 하나인 32만 개를 남기고 픽셀을 덮는 크기를 넓혔습니다. 원하는 장면만 불러보세요.
데이터 검사와 결과의 한계 확인하기
GPU 없이도 영상을 보고 동봉한 실행 기록을 검사할 수 있습니다.
python3 labs/worldgen-scenes/check.py
공개 영상·모델의 해시, 압축 장면의 헤더, 입력 이미지의 생성 마스크, 카메라의 실제 이동, 광선과 좌표의 수치 예시를 확인합니다. 직접 생성한 새 결과는 생성 환경의 Python으로 CPU 검사를 실행하세요.
runs/worldgen-runtime/.venv/bin/python labs/worldgen-scenes/audit.py \
  --folder runs/worldgen/robot-lab
실제 거리 배열과 PLY를 열어 양수·유한값인지, 회전이 정규화되어 있는지, XYZ = 광선 × 거리가 맞는지 확인하고 geometry-audit.json을 저장합니다. 이미지 경로에서는 관측한 파노라마 픽셀을 그대로 유지했는지도 확인합니다. 프롬프트나 패키지 버전을 바꾸면 결과가 달라질 수 있습니다. 파일 이름만 보고 판단하지 말고 데이터 검사도 함께 하세요.
숲길 영상에는 실내보다 투명하게 비거나 구멍이 생긴 영역이 많이 보입니다. 얇은 잎, 깊이가 급변하는 경계, 카메라가 옮겨지면서 드러나는 면은 RGB·거리 한 겹만으로 표현하기 어렵습니다. 기록된 alpha coverage는 렌더링 상태를 확인하는 값이며 형상 정확도 점수가 아닙니다. 생성 공간의 정답 형상이나 검사 시점 PSNR은 없습니다. 검증된 충돌체·미터 단위 크기·관절·로봇 제어기는 포함되지 않습니다.
라이선스: WorldGen 코드, LoRA 카드, DA-2 가중치는 Apache-2.0을 명시합니다. FLUX 원본과 양자화 파생 가중치에는 별도 FLUX.1-dev Non-Commercial 모델 조건이 적용되며, 출력물 이용 범위도 따로 규정합니다. 저장소에는 직접 만든 예제 결과와 코드를 배포하고 모델 가중치는 넣지 않습니다. 영상·입력 출처 · fVDB로 장면 복원하기 · 편집 가능한 집 생성하기.
생성한 로봇 실험실
WorldGen으로 생성한 3D 표면입니다. 실측 거리·충돌체는 포함되지 않습니다. 버튼을 누를 때만 불러옵니다.
드래그: 둘러보기 · 두 손가락/오른쪽 드래그: 이동 · 화면에 포커스를 두고 W/A/S/D: 위치 이동. 원래 시점에서 멀어지면 가려졌던 면의 구멍과 늘어난 표면이 보입니다.
전체 128만 개 중 32만 개를 남기고 크기를 조정한 SPZ 미리보기입니다. 아래 영상은 전체 모델로 렌더링했습니다. 숲길은 실내보다 빈 영역이 많습니다. Spark / World Labs (MIT) · WorldGen / FLUX terms separate
이미지에서 확장한 거실
WorldGen으로 생성한 3D 표면입니다. 실측 거리·충돌체는 포함되지 않습니다. 버튼을 누를 때만 불러옵니다.
드래그: 둘러보기 · 두 손가락/오른쪽 드래그: 이동 · 화면에 포커스를 두고 W/A/S/D: 위치 이동. 원래 시점에서 멀어지면 가려졌던 면의 구멍과 늘어난 표면이 보입니다.
전체 128만 개 중 32만 개를 남기고 크기를 조정한 SPZ 미리보기입니다. 아래 영상은 전체 모델로 렌더링했습니다. 숲길은 실내보다 빈 영역이 많습니다. Spark / World Labs (MIT) · WorldGen / FLUX terms separate
생성한 숲길
WorldGen으로 생성한 3D 표면입니다. 실측 거리·충돌체는 포함되지 않습니다. 버튼을 누를 때만 불러옵니다.
드래그: 둘러보기 · 두 손가락/오른쪽 드래그: 이동 · 화면에 포커스를 두고 W/A/S/D: 위치 이동. 원래 시점에서 멀어지면 가려졌던 면의 구멍과 늘어난 표면이 보입니다.
전체 128만 개 중 32만 개를 남기고 크기를 조정한 SPZ 미리보기입니다. 아래 영상은 전체 모델로 렌더링했습니다. 숲길은 실내보다 빈 영역이 많습니다. Spark / World Labs (MIT) · WorldGen / FLUX terms separate
실행 영상과 기록
이미지 한 장에서 360° 거실로 확장하기
GPU 머신에서 모델을 직접 실행한 뒤 Gaussian PLY에서 카메라를 움직여 렌더링했습니다. 깊이는 추정값이며 실제 거리의 정답은 아닙니다.
실습 소스 코드
setup.sh
GitHub에서 파일 보기#!/usr/bin/env bash
# Linux x86_64 / RTX 5090 recipe, isolated from Isaac Sim and the fVDB renderer.
set -euo pipefail
if command -v uv >/dev/null 2>&1; then
worldgen_uv="$(command -v uv)"
elif [[ -x "$HOME/.local/bin/uv" ]]; then
worldgen_uv="$HOME/.local/bin/uv"
else
echo 'Install uv first: https://docs.astral.sh/uv/getting-started/installation/' >&2
exit 1
fi
worldgen_root="${1:-runs/worldgen-runtime}"
mkdir -p "$worldgen_root"
worldgen_root="$(cd "$worldgen_root" && pwd)"
if [[ ! -x "$worldgen_root/.venv/bin/python" ]]; then "$worldgen_uv" venv --python 3.11 "$worldgen_root/.venv"; fi
worldgen_python="$worldgen_root/.venv/bin/python"
"$worldgen_uv" pip install --python "$worldgen_python" torch==2.7.0 torchvision==0.22.0 --index-url https://download.pytorch.org/whl/cu128
"$worldgen_uv" pip install --python "$worldgen_python" xformers==0.0.30 \
'https://github.com/nunchux-ai/nunchaku/releases/download/v0.2.0/nunchaku-0.2.0%2Btorch2.7-cp311-cp311-linux_x86_64.whl'
"$worldgen_uv" pip install --python "$worldgen_python" diffusers==0.33.1 transformers==4.51.3 peft==0.15.2 \
accelerate==1.7.0 huggingface-hub==0.35.3 timm==1.0.15 opencv-python==4.12.0.88 open3d==0.19.0 \
py360convert einops pillow scikit-image sentencepiece trimesh plyfile imageio imageio-ffmpeg \
matplotlib omegaconf ninja scipy tqdm tensorboard tabulate fvcore iopath viser==1.1.1 setuptools wheel
if [[ ! -d "$worldgen_root/source/.git" ]]; then git clone https://github.com/ZiYang-xie/WorldGen.git "$worldgen_root/source"; fi
git -C "$worldgen_root/source" checkout 7ce7b2767fdf31e2727b69a2e61e2e950e3a017f
if [[ ! -d "$worldgen_root/da2/.git" ]]; then git clone https://github.com/EnVision-Research/DA-2.git "$worldgen_root/da2"; fi
git -C "$worldgen_root/da2" checkout d659838585f2bc9967c7e9367af573795271dbbb
if [[ ! -d "$worldgen_root/pytorch3d/.git" ]]; then git clone https://github.com/facebookresearch/pytorch3d.git "$worldgen_root/pytorch3d"; fi
git -C "$worldgen_root/pytorch3d" checkout ddfc55127fed1a74514cd24db08a7c2e62e76b08
PYTORCH3D_NO_EXTENSION=1 "$worldgen_uv" pip install --python "$worldgen_python" --no-build-isolation --no-deps "$worldgen_root/pytorch3d"
"$worldgen_uv" pip install --python "$worldgen_python" --no-deps \
'git+https://github.com/EasternJournalist/utils3d.git@3913c65d81e05e47b9f367250cf8c0f7462a0900' \
-e "$worldgen_root/source" -e "$worldgen_root/da2/src"
"$worldgen_python" -c 'import torch; from worldgen import WorldGen; from nunchaku.utils import get_precision; print(torch.__version__, torch.cuda.get_device_name(0), get_precision())'
generate.py
GitHub에서 파일 보기"""Generate a real WorldGen panorama, DA-2 distance field, Gaussian PLY and mesh.
Use the dedicated Python 3.11 runtime in setup.sh. FLUX approvals are required.
The image adapter uses known pinhole calibration instead of treating a normal
camera photograph as an equirectangular panorama. No model weights are changed.
"""
import argparse
import hashlib
import importlib.metadata
import json
import resource
import subprocess
import time
from pathlib import Path
import numpy as np
from PIL import Image
import torch
import torch.nn.functional as F
from huggingface_hub import snapshot_download
from plyfile import PlyData, PlyElement
def project_image(image, intrinsics, width, height, device="cuda"):
"""Inverse-project the panorama's rays into the calibrated source camera."""
from worldgen.utils.general_utils import pano_unit_rays
source = np.array(image.convert("RGB"))
sh, sw = source.shape[:2]
K = np.asarray(intrinsics, dtype=float)
rays = pano_unit_rays(height, width, device)
z = rays[..., 2]
u = K[0, 0] * rays[..., 0] / z.clamp(min=1e-6) + K[0, 2]
v = K[1, 1] * rays[..., 1] / z.clamp(min=1e-6) + K[1, 2]
valid = (z > 0) & (u >= 0) & (u <= sw-1) & (v >= 0) & (v <= sh-1)
grid = torch.stack((u/(sw-1)*2-1, v/(sh-1)*2-1), dim=-1)
rgb = torch.tensor(source, device=device, dtype=torch.float32).permute(2, 0, 1)[None]/255
mapped = F.grid_sample(rgb, grid[None], mode="bilinear", align_corners=True, padding_mode="zeros")[0].permute(1, 2, 0)
mapped = (mapped * valid[..., None] * 255).round().clamp(0, 255).to(torch.uint8).cpu().numpy()
mask = (~valid).to(torch.uint8).cpu().numpy()*255
return Image.fromarray(mapped), Image.fromarray(mask), float(valid.float().mean())
def export_ply(splat, path):
"""Export standard 3DGS fields: log scale, logit opacity and wxyz rotation."""
fields = ["x", "y", "z", "nx", "ny", "nz", "f_dc_0", "f_dc_1", "f_dc_2", "opacity",
"scale_0", "scale_1", "scale_2", "rot_0", "rot_1", "rot_2", "rot_3"]
values = np.concatenate((splat.centers, np.zeros_like(splat.centers),
(splat.rgbs-.5)/.28209479177387814,
np.log(np.clip(splat.opacities, 1e-6, 1-1e-6)/np.clip(1-splat.opacities, 1e-6, 1)),
np.log(np.maximum(splat.scales, 1e-5)), splat.rotations), axis=1).astype(np.float32)
assert np.isfinite(values).all(), "Non-finite Gaussian attributes"
assert np.allclose(np.linalg.norm(splat.rotations, axis=1), 1, atol=1e-3)
vertices = np.empty(len(values), dtype=[(field, "f4") for field in fields])
for i, field in enumerate(fields):
vertices[field] = values[:, i]
PlyData([PlyElement.describe(vertices, "vertex")], text=False).write(path)
return {"gaussians": len(values), "all_finite": True,
"bounds": [splat.centers.min(0).tolist(), splat.centers.max(0).tolist()]}
def main():
parser = argparse.ArgumentParser()
parser.add_argument("--output", type=Path, required=True)
parser.add_argument("--prompt", required=True)
parser.add_argument("--image", type=Path)
parser.add_argument("--intrinsics", type=Path)
parser.add_argument("--pins", type=Path, default=Path(__file__).with_name("model-pins.json"))
parser.add_argument("--width", type=int, default=1600)
parser.add_argument("--steps", type=int, default=50)
parser.add_argument("--seed", type=int, default=42)
args = parser.parse_args()
assert args.width % 32 == 0
if args.image and not args.intrinsics:
parser.error("The image route requires the camera's intrinsics JSON")
output = args.output
output.mkdir(parents=True, exist_ok=True)
pins = json.loads(args.pins.read_text())
snapshots = {r["repo"]: snapshot_download(r["repo"], revision=r["revision"],
ignore_patterns=r.get("omitted") or None, max_workers=3) for r in pins["models"]}
from da2.model.spherevit import SphereViT
import da2.model.dinov2.attention as da2_attention
# DA-2 already provides this PyTorch SDPA fallback. Old xFormers has no sm_120 kernel.
da2_attention.XFORMERS_AVAILABLE = False
from nunchaku import NunchakuFluxTransformer2dModel
from worldgen import WorldGen
import worldgen.worldgen as wg
from worldgen.pano_depth import DA2_CONFIG, pred_pano_depth
from worldgen.pano_gen import gen_pano_image, gen_pano_fill_image
from worldgen.models.flux_pano_gen_pipeline import FluxPipeline
from worldgen.models.flux_pano_fill_pipeline import FluxFillPipeline
from worldgen.utils.lora_utils import load_and_fix_lora
import open3d as o3d
torch.backends.cudnn.enabled = False
torch.manual_seed(args.seed)
torch.cuda.reset_peak_memory_stats()
mode = "i2s" if args.image else "t2s"
base = "black-forest-labs/FLUX.1-Fill-dev" if args.image else "black-forest-labs/FLUX.1-dev"
quant = "mit-han-lab/svdq-fp4-flux.1-fill-dev" if args.image else "mit-han-lab/svdq-fp4-flux.1-dev"
lora_file = "worldgen_img2scene.safetensors" if args.image else "worldgen_text2scene.safetensors"
def depth_model(device):
return SphereViT.from_pretrained(snapshots["haodongli/DA-2"], config=DA2_CONFIG).eval().to(device)
def panorama_model(lora_path=None, device="cuda", low_vram=True):
transformer = NunchakuFluxTransformer2dModel.from_pretrained(snapshots[quant], offload=True)
pipe_type = FluxFillPipeline if args.image else FluxPipeline
pipe = pipe_type.from_pretrained(snapshots[base], transformer=transformer, torch_dtype=torch.bfloat16)
state_dict, _ = load_and_fix_lora(str(Path(snapshots["LeoXie/WorldGen"])/"models--WorldGen-Flux-Lora"/lora_file))
transformer.update_lora_params(state_dict)
pipe.enable_model_cpu_offload()
pipe.enable_vae_tiling()
return pipe
# Keep the upstream WorldGen generation, depth, splat and mesh implementations.
# The builders above select immutable model snapshots and FP4/offload explicitly.
wg.build_depth_model = depth_model
wg.build_pano_gen_model = panorama_model
wg.build_pano_fill_model = panorama_model
started = time.monotonic()
model = WorldGen(mode=mode, resolution=args.width, device=torch.device("cuda"), low_vram=True)
loaded_seconds = time.monotonic()-started
print("Models loaded:", mode, "RTX 5090 / FP4 / CPU offload", flush=True)
height = args.width//2
stage = time.monotonic()
conditioning = None
with torch.inference_mode():
if args.image:
image = Image.open(args.image).convert("RGB")
intrinsics = json.loads(args.intrinsics.read_text())
assert list(image.size) == intrinsics["resolution"]
mapped, mask, coverage = project_image(image, intrinsics["K"], args.width, height)
mapped.save(output/"conditioning.png")
mask.save(output/"generation-mask.png")
image.save(output/"input.png")
panorama = gen_pano_fill_image(model.pano_gen_model, mapped, mask, prompt=args.prompt,
seed=args.seed, num_inference_steps=args.steps, height=height, width=args.width)
generated = np.array(panorama)
keep = np.array(mask)==0
generated[keep] = np.array(mapped)[keep]
panorama = Image.fromarray(generated)
conditioning = {"source_sha256": hashlib.sha256(args.image.read_bytes()).hexdigest(),
"source_resolution": list(image.size), "intrinsics": intrinsics["K"],
"observed_panorama_fraction": coverage,
"max_preserved_rgb_error": int(np.abs(generated[keep].astype(int)-np.array(mapped)[keep].astype(int)).max()),
"projection": "known pinhole K to equirectangular rays; white mask is generated"}
else:
panorama = gen_pano_image(model.pano_gen_model, prompt=args.prompt, seed=args.seed,
num_inference_steps=args.steps, height=height, width=args.width)
torch.cuda.synchronize()
generation_seconds = time.monotonic()-stage
panorama.save(output/"panorama.png")
print("Panorama saved", list(panorama.size), flush=True)
stage = time.monotonic()
predictions = pred_pano_depth(model.depth_model, panorama)
depth = predictions["distance"].float().cpu().numpy()
assert np.isfinite(depth).all() and depth.min()>0
np.save(output/"distance.npy", depth)
splat = model.depth2gs(predictions)
result = export_ply(splat, output/"scene.ply")
mesh = model.depth2mesh(predictions)
assert o3d.io.write_triangle_mesh(str(output/"scene-mesh.ply"), mesh)
assert o3d.io.write_triangle_mesh(str(output/"scene-mesh.glb"), mesh)
torch.cuda.synchronize()
geometry_seconds = time.monotonic()-stage
report = {"status": "success", "mode": mode, "prompt": args.prompt, "seed": args.seed,
"steps": args.steps, "resolution": list(panorama.size), "conditioning": conditioning,
"distance": {"shape": list(depth.shape), "min": float(depth.min()), "max": float(depth.max()),
"scale": "DA-2 scale-invariant estimate normalized to max 20; not measured metric distance"},
"gaussians": result, "mesh": {"vertices": len(mesh.vertices), "triangles": len(mesh.triangles)},
"seconds": {"load": loaded_seconds, "panorama": generation_seconds, "geometry": geometry_seconds},
"runtime": {"gpu": torch.cuda.get_device_name(0), "torch": torch.__version__, "cuda": torch.version.cuda,
"packages": {n: importlib.metadata.version(n) for n in ["nunchaku", "diffusers", "transformers", "da2", "worldgen", "pytorch3d"]},
"peak_gpu_gb": torch.cuda.max_memory_allocated()/1e9, "max_rss_gb": resource.getrusage(resource.RUSAGE_SELF).ru_maxrss/1e6},
"model_revisions": pins["models"], "source_revisions": pins["source_revisions"]}
for filename in ["panorama.png", "distance.npy", "scene.ply", "scene-mesh.ply", "scene-mesh.glb"]:
path = output/filename
report.setdefault("artifacts", {})[filename] = {"bytes": path.stat().st_size, "sha256": hashlib.sha256(path.read_bytes()).hexdigest()}
(output/"result.json").write_text(json.dumps(report, indent=2)+"\n")
print(json.dumps({"mode": mode, "seconds": report["seconds"], "gaussians": result["gaussians"]}), flush=True)
if __name__ == "__main__":
main()
render.py
GitHub에서 파일 보기"""Render a translated 360-degree camera path through WorldGen's actual 3D PLY.
Run with the separate fVDB Reality Capture runtime, not the WorldGen environment.
"""
import argparse
import hashlib
import json
import math
import subprocess
from pathlib import Path
import numpy as np
import torch
from PIL import Image
from fvdb_reality_capture import GaussianSplat3d
def main():
p=argparse.ArgumentParser()
p.add_argument('--scene',type=Path,required=True)
p.add_argument('--output',type=Path,required=True)
p.add_argument('--ffmpeg',default='ffmpeg')
p.add_argument('--frames',type=int,default=480)
p.add_argument('--fps',type=int,default=24)
a=p.parse_args()
a.output.mkdir(parents=True,exist_ok=True)
torch.backends.cudnn.enabled=False
model,_=GaussianSplat3d.from_ply(str(a.scene),device='cuda')
width,height=960,540
focal=width/(2*math.tan(math.radians(80)/2))
K=np.array([[focal,0,width/2],[0,focal,height/2],[0,0,1]],dtype=np.float32)
camera_json={'convention':'OpenCV world-to-camera; x right, y down, z forward; arbitrary WorldGen distance scale',
'resolution':[width,height],'K':K.tolist(),'fps':a.fps,'frames':[]}
video=a.output/'free-view.mp4'
encoder=subprocess.Popen([a.ffmpeg,'-hide_banner','-loglevel','error','-y','-f','rawvideo','-pix_fmt','rgb24',
'-s',f'{width}x{height}','-r',str(a.fps),'-i','pipe:0','-an','-c:v','libx264','-preset','fast',
'-crf','23','-pix_fmt','yuv420p','-movflags','+faststart',str(video)],stdin=subprocess.PIPE)
for i,t in enumerate(np.linspace(0,1,a.frames,endpoint=False)):
yaw=2*math.pi*t
# Translation really changes the optical center; this is not a 2D panorama crop.
center=np.array([.20*math.sin(2*yaw),.045*math.sin(yaw),.15*math.sin(yaw)])
forward=np.array([math.sin(yaw),.055*math.sin(yaw),math.cos(yaw)])
forward/=np.linalg.norm(forward)
right=np.cross([0,1,0],forward); right/=np.linalg.norm(right)
down=np.cross(forward,right)
c2w=np.eye(4,dtype=np.float32); c2w[:3,:3]=np.stack([right,down,forward],axis=1); c2w[:3,3]=center
w2c=np.linalg.inv(c2w)
with torch.inference_mode():
rgb,alpha=model.render_images(torch.tensor(w2c[None],device='cuda'),torch.tensor(K[None],device='cuda'),width,height,.005,100.)
pixels=(rgb[0,:,:,:3].clamp(0,1).cpu().numpy()*255).astype(np.uint8)
encoder.stdin.write(pixels.tobytes())
camera_json['frames'].append({'frame':i,'center':center.tolist(),'world_to_camera':w2c.tolist(),'mean_alpha':float(alpha.mean())})
if i in (0,a.frames//4,a.frames//2,a.frames*3//4):
Image.fromarray(pixels).save(a.output/f'view-{i:04}.jpg',quality=90)
print('Rendered',i,'/',a.frames,flush=True)
encoder.stdin.close()
if encoder.wait(): raise RuntimeError('ffmpeg failed')
assert np.mean([f['mean_alpha'] for f in camera_json['frames']])>.5
(a.output/'cameras.json').write_text(json.dumps(camera_json,indent=2)+'\n')
report={'frames':a.frames,'fps':a.fps,'duration_seconds':a.frames/a.fps,'resolution':[width,height],
'renderer':'fVDB Reality Capture','torch':torch.__version__,'gaussians':int(model.num_gaussians),
'center_range':np.ptp([f['center'] for f in camera_json['frames']],axis=0).tolist(),
'mean_alpha':float(np.mean([f['mean_alpha'] for f in camera_json['frames']])),
'mp4_sha256':hashlib.sha256(video.read_bytes()).hexdigest(),'mp4_bytes':video.stat().st_size,
'cameras_sha256':hashlib.sha256((a.output/'cameras.json').read_bytes()).hexdigest()}
(a.output/'render.json').write_text(json.dumps(report,indent=2)+'\n')
print(json.dumps(report),flush=True)
if __name__=='__main__': main()
audit.py
GitHub에서 파일 보기"""Validate newly generated PLY/distance files on CPU, and save concrete samples."""
import argparse
import json
import math
from pathlib import Path
import numpy as np
from PIL import Image
from plyfile import PlyData
def audit(folder):
record=json.loads((folder/'result.json').read_text())
depth=np.load(folder/'distance.npy');h,w=depth.shape
vertices=PlyData.read(folder/'scene.ply')['vertex'].data
assert len(vertices)==h*w==record['gaussians']['gaussians']
assert np.isfinite(depth).all() and (depth>0).all()
assert all(np.isfinite(vertices[k]).all() for k in vertices.dtype.names)
rgb=np.array(Image.open(folder/'panorama.png'))
samples=[]
for y,x in [(h//2,w//2),(3*h//8,5*w//16),(5*h//8,11*w//16),(h//8,w//8)]:
v=vertices[y*w+x];phi=((x+.5)/w)*2*math.pi-math.pi;theta=((y+.5)/h)*math.pi-math.pi/2
ray=np.array([math.cos(theta)*math.sin(phi),math.sin(theta),math.cos(theta)*math.cos(phi)])
xyz=np.array([float(v[k]) for k in ['x','y','z']]);distance=float(depth[y,x])
assert np.max(np.abs(xyz-ray*distance))<1e-4
samples.append({'pixel':[x,y],'rgb':list(map(int,rgb[y,x])),'ray':ray.tolist(),'distance':distance,'xyz':xyz.tolist()})
norms=np.linalg.norm(np.stack([vertices[f'rot_{i}'] for i in range(4)],-1),axis=1)
assert np.allclose(norms,1,atol=1e-3)
result={'samples':samples,'distance_finite':True,'distance_positive':True,'finite_ply_fields':True,
'opacity_min':float((1/(1+np.exp(-vertices['opacity']))).min()),
'quaternion_norm_range':[float(norms.min()),float(norms.max())]}
if record['mode']=='i2s':
mask=np.array(Image.open(folder/'generation-mask.png'))
conditioning=np.array(Image.open(folder/'conditioning.png'))
assert np.any(mask==0) and np.any(mask==255)
assert np.array_equal(conditioning[mask==0],rgb[mask==0])
assert record['conditioning']['max_preserved_rgb_error']==0
(folder/'geometry-audit.json').write_text(json.dumps(result,indent=2)+'\n')
print(f'{folder.name}: finite geometry, unit rotations, ray×distance positions and conditioning verified.')
if __name__=='__main__':
p=argparse.ArgumentParser();p.add_argument('--folder',type=Path,required=True)
audit(p.parse_args().folder)
preview.py
GitHub에서 파일 보기"""Create a labeled quarter-density browser preview; full PLY stays untouched."""
import argparse
import json
from pathlib import Path
import numpy as np
from plyfile import PlyData, PlyElement
p=argparse.ArgumentParser()
p.add_argument('--folder',type=Path,required=True)
a=p.parse_args()
r=json.loads((a.folder/'result.json').read_text())
w,h=r['resolution']
v=PlyData.read(a.folder/'scene.ply')['vertex'].data
assert len(v)==h*w
# Retain one of four panorama pixels and widen its tangent footprint.
small=v.reshape(h,w)[::2,::2].copy().reshape(-1)
for field in ('scale_0','scale_1'): small[field]+=np.log(2.)
PlyData([PlyElement.describe(small,'vertex')],text=False).write(a.folder/'preview.ply')
print(json.dumps({'source_gaussians':len(v),'preview_gaussians':len(small),'method':'2x2 image-grid stride, tangent scales doubled; DC color unchanged'}))
model-pins.json
GitHub에서 파일 보기{
"source_revisions": {
"WorldGen": "7ce7b2767fdf31e2727b69a2e61e2e950e3a017f",
"DA-2": "d659838585f2bc9967c7e9367af573795271dbbb",
"PyTorch3D": "ddfc55127fed1a74514cd24db08a7c2e62e76b08"
},
"models": [
{
"repo": "black-forest-labs/FLUX.1-dev",
"revision": "45d95c497444bbaebe766e1528792fc9158c0c3a",
"omitted": [
"transformer/*"
]
},
{
"repo": "black-forest-labs/FLUX.1-Fill-dev",
"revision": "7326a96224b2513681b5d97281c83af967926bb6",
"omitted": [
"transformer/*"
]
},
{
"repo": "mit-han-lab/svdq-fp4-flux.1-dev",
"revision": "70ecf6cfde1525d88ec386fbec5a3a8cdfc33ea4",
"omitted": []
},
{
"repo": "mit-han-lab/svdq-fp4-flux.1-fill-dev",
"revision": "cec73b4a4e208b28df9e4f977d775e70edff71a8",
"omitted": []
},
{
"repo": "LeoXie/WorldGen",
"revision": "2e2b2cb4dc3144a65481f0ca26b892584436868c",
"omitted": []
},
{
"repo": "haodongli/DA-2",
"revision": "0d55ccb5e46b8ed4715fae3a4c04fc897f1689f3",
"omitted": []
}
]
}
check.py
GitHub에서 파일 보기"""Inspect published WorldGen evidence with Python's standard library; no GPU."""
import gzip
import hashlib
import json
import math
from pathlib import Path
import struct
def main():
root=Path(__file__).resolve().parents[2]
folder=root/'labs/worldgen-scenes'
record=json.loads((folder/'recorded.json').read_text())
for name,digest in record['implementation_sha256'].items():
assert hashlib.sha256((folder/name).read_bytes()).hexdigest()==digest,name
assert {row['mode'] for row in record['cases']}=={'t2s','i2s'}
assert len(record['cases'])==3
for case in record['cases']:
evidence=folder/'evidence'/case['id']
result=json.loads((evidence/'result.json').read_text())
audit=json.loads((evidence/'geometry-audit.json').read_text())
cameras=json.loads((evidence/'cameras.json').read_text())
assert result['status']=='success' and result['resolution']==[1600,800]
assert result['gaussians']['gaussians']==1_280_000 and result['gaussians']['all_finite']
assert result['distance']['shape']==[800,1600] and result['distance']['max']==20
assert audit['distance_finite'] and audit['distance_positive'] and audit['finite_ply_fields']
assert all(abs(v-1)<1e-3 for v in audit['quaternion_norm_range'])
for sample in audit['samples']:
assert math.isclose(sum(v*v for v in sample['ray']),1,abs_tol=1e-5)
assert max(abs(x-r*sample['distance']) for x,r in zip(sample['xyz'],sample['ray']))<1e-4
assert len(cameras['frames'])==480 and cameras['fps']==24
centers=[f['center'] for f in cameras['frames']]
assert max(c[0] for c in centers)-min(c[0] for c in centers)>.39
for frame in cameras['frames']:
# W2C must map the documented optical center back to the origin.
for row in frame['world_to_camera'][:3]:
assert abs(sum(row[j]*frame['center'][j] for j in range(3))+row[3])<1e-5
assert hashlib.sha256((evidence/'cameras.json').read_bytes()).hexdigest()==case['render']['cameras_sha256']
for name,meta in case['published'].items():
data=(root/'site/public/showcase'/name).read_bytes()
assert len(data)==meta['bytes'] and hashlib.sha256(data).hexdigest()==meta['sha256'],name
spz=gzip.decompress((root/'site/public/showcase'/case['web_preview']['file']).read_bytes())
magic,version,count,degree,_,_,_=struct.unpack_from('<IIIBBBB',spz)
assert magic==int.from_bytes(b'NGSP','little') and version==3 and count==320_000 and degree==0
assert len(spz)==16+count*20
assert .5<case['render']['mean_alpha']<=1
if case['mode']=='i2s':
assert result['conditioning']['max_preserved_rgb_error']==0
assert .1<result['conditioning']['observed_panorama_fraction']<.3
assert hashlib.sha256((folder/'evidence/input.png').read_bytes()).hexdigest()==result['conditioning'].get('published_source_sha256', result['conditioning']['source_sha256'])
print('WorldGen: 3 generated scenes, 1,440 translated camera poses, 3 MP4s and 3 compressed previews verified.')
if __name__=='__main__': main()